
YouTube 影片筆記
用陣列相加拆解 CUDA 從 Kernel 到 Warp 的 GPU 執行流程
原片標題:CUDA 是什么?从 Kernel、Block 到 Warp 看懂 GPU 并行计算
原片說明
CUDA 不是 GPU,而是让程序员使用 NVIDIA GPU 进行计算的平台与编程模型。
这支影片用「两个数组逐项相加」的例子,带你看懂 CUDA 程序如何从一个 Kernel 出发,把工作组织成线程、Thread Block 与 Grid,再由 GPU 的 SM 以 Warp 为单位调度执行。也会说明 SIMT 的基本概念,以及 CPU 内存、PCIe 和 GPU 显示记忆体之间的数据传输为什么会影响运算效率。
影片中的百万个线程是任务规模的示例,并不代表 GPU 有百万个计算核心,也不代表所有线程会在同一时刻执行。
#CUDA #NVIDIA #GPU
每次看到「輝達為什麼這麼強」的討論,留言區一定有人喊 CUDA,但我其實一直說不出它到底是什麼。奇點散戶這次用兩個陣列相加當例子,把 Kernel、Thread Block、Grid 一路講到 Warp 怎麼被 SM 調度,總算讓我搞懂它跟 GPU 本身是兩回事。
影片時間軸
- 00:29寫一個 Kernel,只描述單一位置怎麼相加
- 00:54百萬個數字拆成百萬個線程,每 256 個裝進一個 block
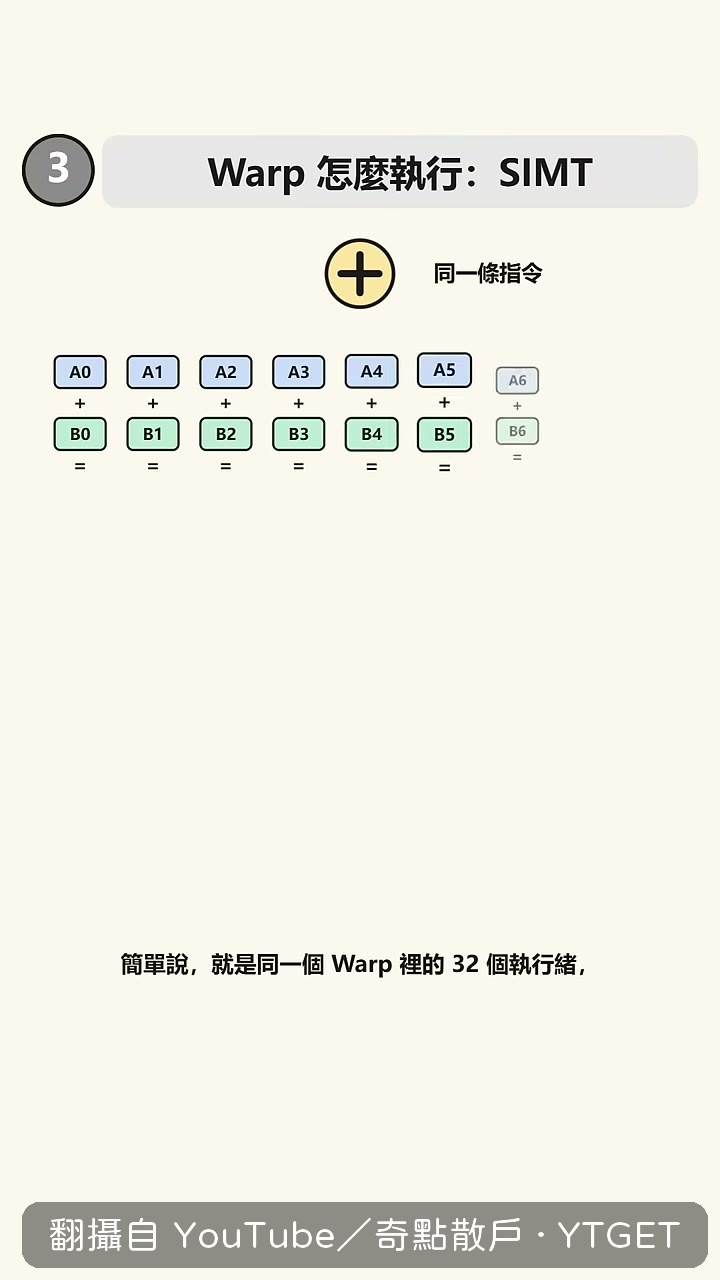
- 01:23線程塊進 SM 後,每 32 個線程切成一個 Warp
- 01:31Warp 內 32 個線程執行同一指令、處理不同數據
- 01:59數據從 CPU 內存經 PCIe 搬到顯存,傳輸跟不上就得等
- 02:18優化重點轉為減少搬運、提高顯存訪問效率
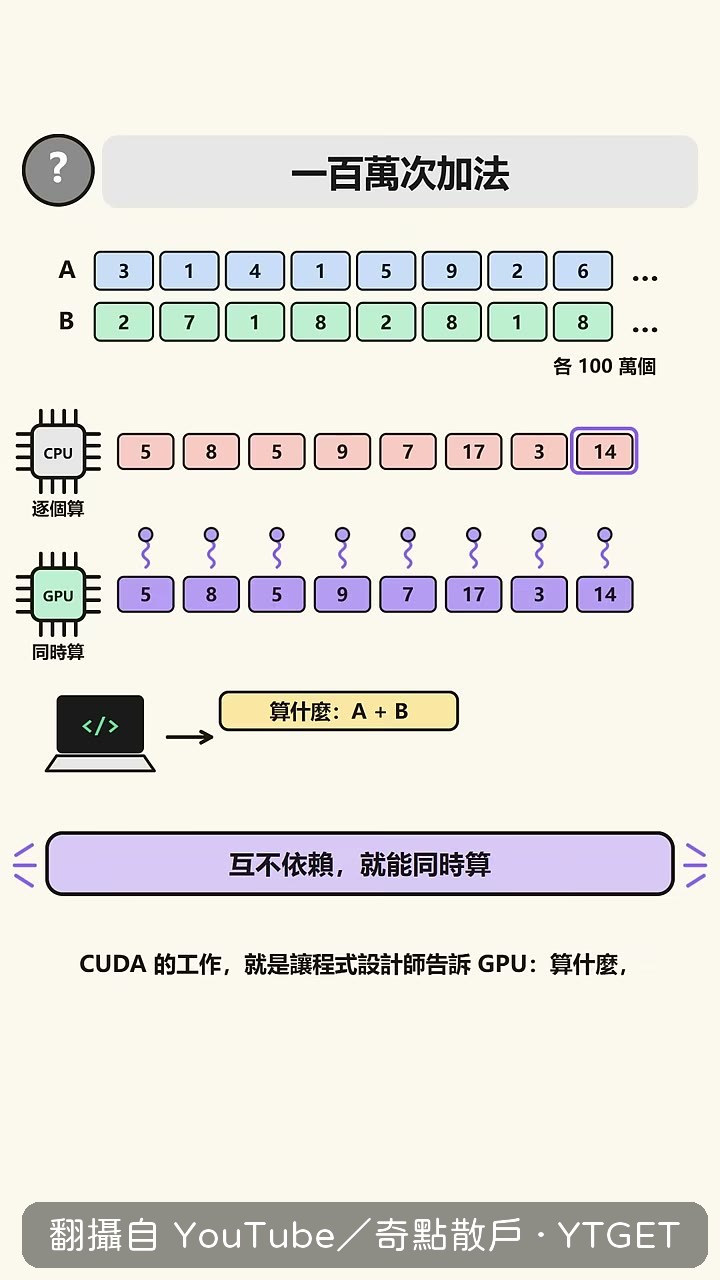
Kernel 只寫一個數字怎麼算
這段是整支影片最清楚的地方。一百萬次加法用 CPU 就是寫個迴圈從頭跑到尾,但這些加法彼此不依賴,本來就能同時做。CUDA 的做法是你只寫「讀 A、讀 B、相加、寫進 C」這一個動作,剩下的分配交給它。這個對比一出來,Kernel 到底是什麼就沒那麼抽象了。
百萬線程不等於百萬核心
我原本也以為線程開越多算越快,影片特別停下來澄清:一百萬個線程不代表一百萬個計算核心,也不代表它們真的同時執行。GPU 是看硬體資源分批安排,線程塊排隊進 SM,再切成 Warp 輪流調度。這段算是把常見的誤解直接拆掉,沒有含糊帶過。
資料搬運才是真正的瓶頸
最後講資料從哪裡來,我覺得才是重點。GPU 算得再快,資料卡在 CPU 記憶體跟視訊記憶體之間透過 PCIe 搬運,計算單元也只能空等。所以最佳化減少不必要的搬運、提高視訊記憶體訪問效率,視訊記憶體頻寬之所以重要也是這個原因。前面鋪陳的架構,到這裡才接上實務。
值得下載嗎:值得,十分鐘把 CUDA 從名詞變成你看得懂的執行流程,想入門 GPU 運算留著當複習很划算。
覺得這篇筆記有幫助嗎?