
YouTube 影片筆記
Claude Haiku 5.5 定價拆解與電腦操作實測
原片標題:EP419 - 五分鐘看完 Claude Haiku ! 便宜 90%?多強?該用在哪裡?
原片說明
便宜 90% 這種數字,我第一個反應是「真的假的」,結果懶人報一開頭就說這 90% 有條件。Haiku 5.5 的價格切成兩段,prompt 在 10 萬 token 以內才是輸入 $0.10、輸出 $0.50,超過就變成 $0.50 跟 $2.50,折扣直接砍半。所以官方講的平均便宜 75%,其實是拿舊請求的分佈算出來的,不是每個人都拿得到。
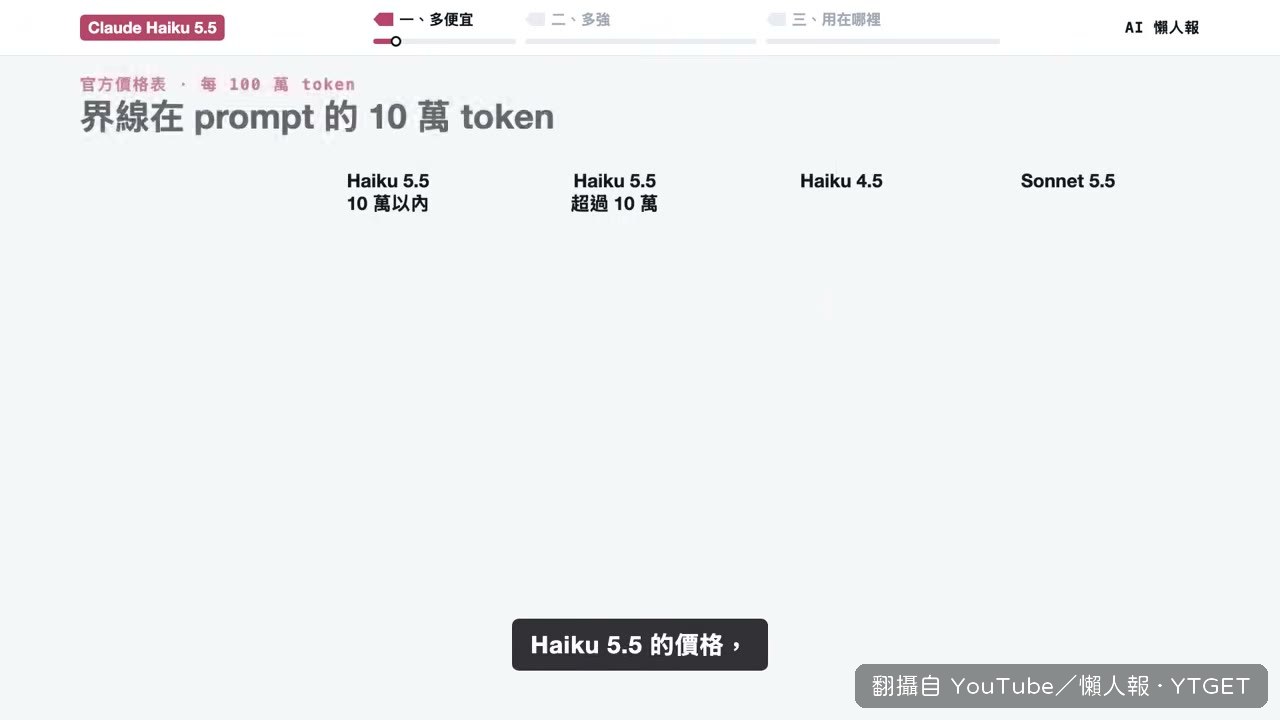
便宜 90% 是有條件的
Haiku 5.5 的定價不看方案,看你的 prompt 有多長。10 萬 token 以內,輸入 $0.10、輸出 $0.50;超過 10 萬,輸入跳到 $0.50、輸出 $2.50。Haiku 4.5 是輸入一塊、輸出五塊,不分長短,所以短 prompt 便宜 90%,長 prompt 只便宜一半。官方說以前送給 Haiku 4.5 的請求有九成都在 10 萬以內,那個 75% 是這樣平均出來的。另外它換了新 tokenizer,做同一件事會多用一點 token,常常丟整個 repo 的人,實際折扣會更靠近 50%。
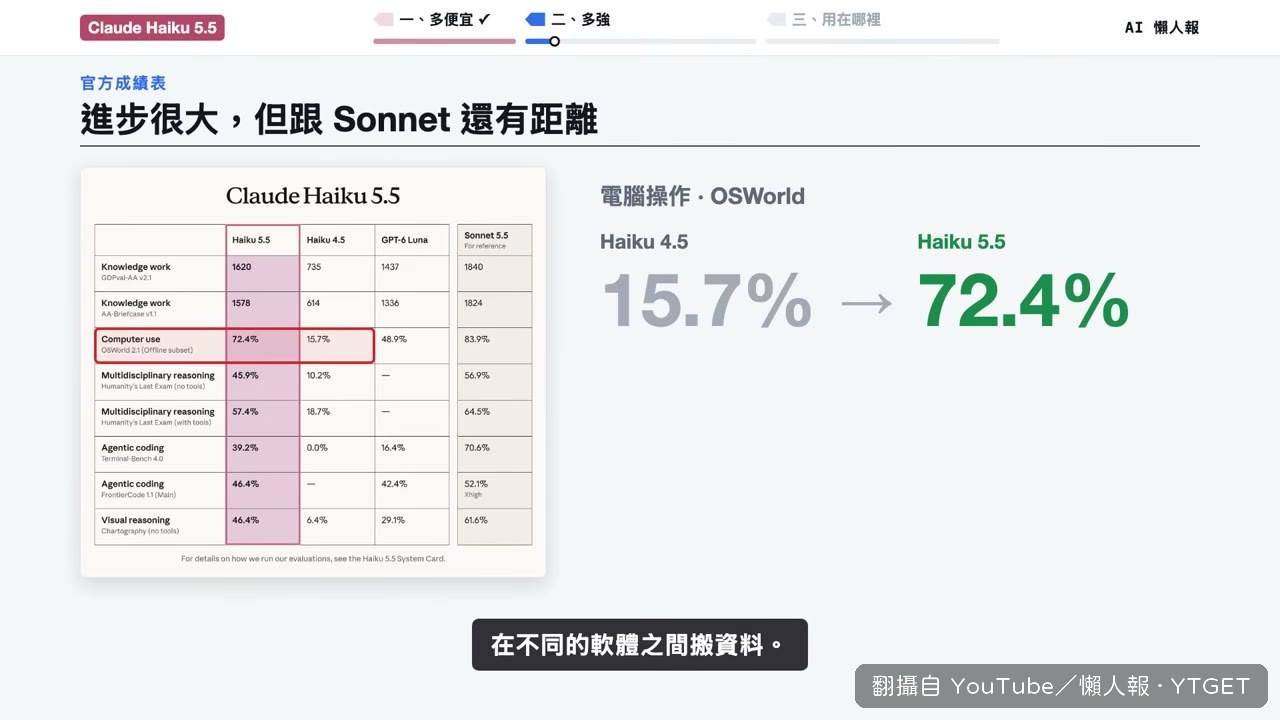
電腦操作很強,寫程式還是差一倍
電腦操作這一題,Haiku 4.5 只有 15.7%,Haiku 5.5 拉到 72.4%,跨領域推理也從 10.2% 拉到 45.9%,差不多四倍。同一個表上,OpenAI 的 GPT-6 Luna 在電腦操作是 48.9%,Haiku 5.5 高出二十幾個百分點。但換到 Terminal-Bench,在終端機裡跑完整串工程任務,Haiku 5.5 是 39.2%,Sonnet 5.5 是 70.6%,差了將近一倍。官方自己也說,複雜的寫程式工作還是交給 Sonnet 或 Opus。
影片時間軸
- 00:00開場先報 Haiku 4.5 跟 5.5 的價差,說等於便宜 90%
- 00:46拆解兩段式定價,10 萬 token 是那條分界線
- 01:40看電腦操作與推理成績,順便對比 GPT-6 Luna
- 02:27講 effort 五格,電腦操作開 Max 划算、推理題反而該換 Sonnet
- 03:08雞蛋掉落實驗,Opus 規劃加十個 Haiku 動手,試到 75 個設計
- 04:35收尾給三件今天就能做的事,並公佈 API 額度
effort 不是開到最大就好
Haiku 5.5 是第一個能調 effort 的 Haiku,從 Low 到 Max 一共五格。官方那張圖看下來,電腦操作這一題,Haiku 開到 Max 花的錢比 Sonnet 開最低還少,分數還比較高,這題用 Haiku 是對的。但換成推理考題就反過來,Haiku 開到 Max 比 Sonnet 中間檔位還貴,分數卻比較低。所以題目夠難的時候,直接換 Sonnet、effort 開低一點,反而更省。
讓大模型想,讓 Haiku 做
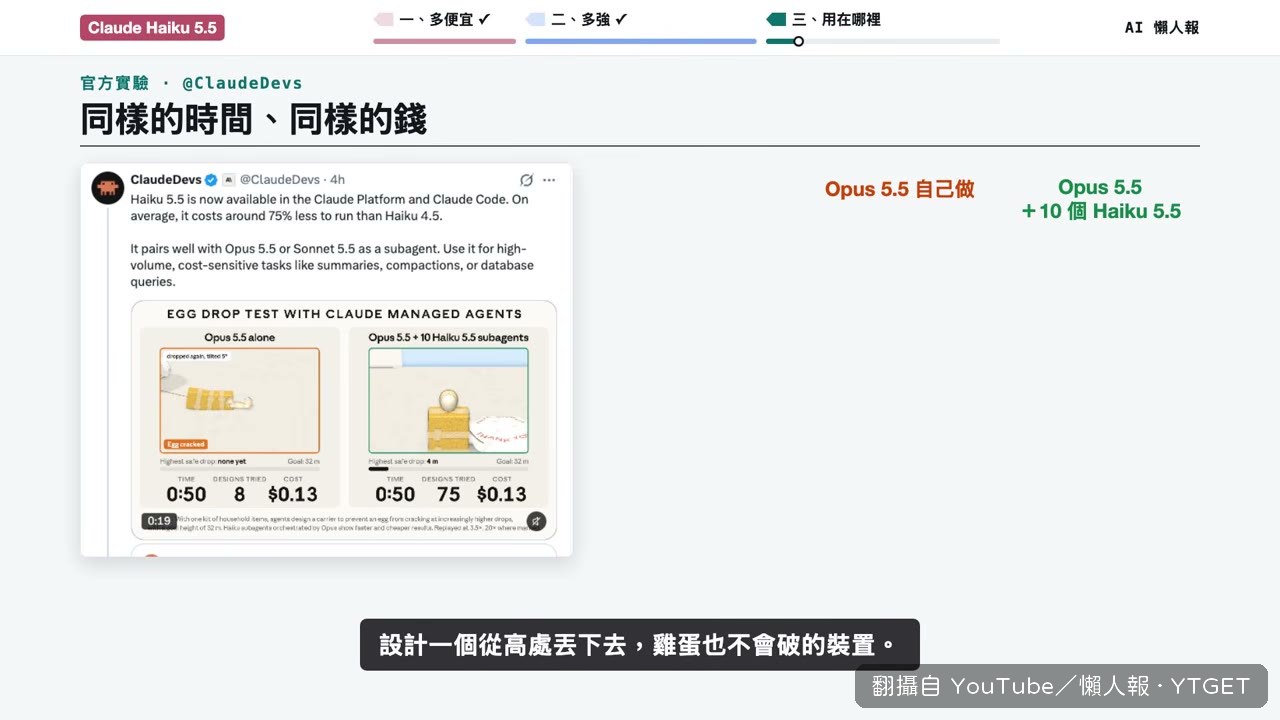
官方那個實驗很直白:叫 AI 用家裡找得到的東西做一個雞蛋從高處丟下去不會破的裝置。左邊 Opus 5.5 自己做,右邊 Opus 規劃、派十個 Haiku 動手。同樣跑 50 秒、同樣花 $0.13,Opus 自己只試了八個設計,雞蛋還是破;加上 Haiku 之後試了 75 個,已經有一個從四公尺丟下去不會破。適合交給它的工作包括大量摘要分類、對話太長時的 compaction、即時客服跟語音助理,還有重複的瀏覽器與桌面操作。
值得下載嗎:值得,五分鐘把價格陷阱、benchmark 落差跟 effort 怎麼開講得很清楚,尤其那個「便宜 90% 只限 10 萬 token 以內」的提醒,比規格表本身有用。