
YouTube 影片筆記
用四層金字塔判斷何時該用向量資料庫而非關鍵字搜尋
原片標題:向量資料庫還需要嗎?用 IBM 的四層金字塔判斷,什麼時候 grep 就夠了
原片說明
同事問「怎麼重設密碼」,解法卻藏在一張叫「更新後登入一直轉圈」的客服工單裡。如果只搜「密碼」,這張工單很容易被漏掉。這就是語意搜尋派得上用場的地方。那麼,為了找到它,值得另外架一套向量資料庫嗎?
這支短片整理 IBM Technology 講者 Martin Keen 的四層檢索金字塔。資料少時,可以直接讓 AI 讀完。文件有固定用詞時,AI Agent 可以用 grep 搜尋、看結果,再換個詞試一次。當使用者和文件描述同一件事卻用不同詞彙,就值得在現有資料庫加入向量索引。等到向量達百萬量級、查詢又頻繁,才進一步評估專用向量資料庫。
00:00 為什麼有人用 grep 取代向量資料庫?
00:20 四層檢索金字塔怎麼看
00:51 AI 自己換詞搜尋、長上下文與向量化成本
01:24 從客服工單看懂「語意落差」
02:00 向量數量和查詢速度,如何影響選擇
02:15 用兩個問題判斷自己的專案需要哪一層
內容來源:IBM Technology〈Are Vector Databases Still Needed?〉,講者 Martin Keen。本片使用原片節錄與 AI 中文旁白。
#向量資料庫 #語意搜尋 #RAG #AIAgent #Shorts
有人說向量資料庫要過時了,我第一個反應是「真的假的,那我之前學的不就白學」?結果 Martin Keen 根本沒說它沒用,而是叫你先看清楚自己手上這批資料落在四層金字塔的哪一階,別一開始就攻頂。這支短片就是把這個判斷順序講清楚。
影片時間軸
- 00:00開場先問向量資料庫是不是過時了,帶出 grep 取代它的討論
- 00:28從底層「全部丟給 AI 讀」一路講到最上層的專用向量資料庫
- 00:51拆解三個理由:AI 自己換詞搜、上下文變大、向量化要花錢
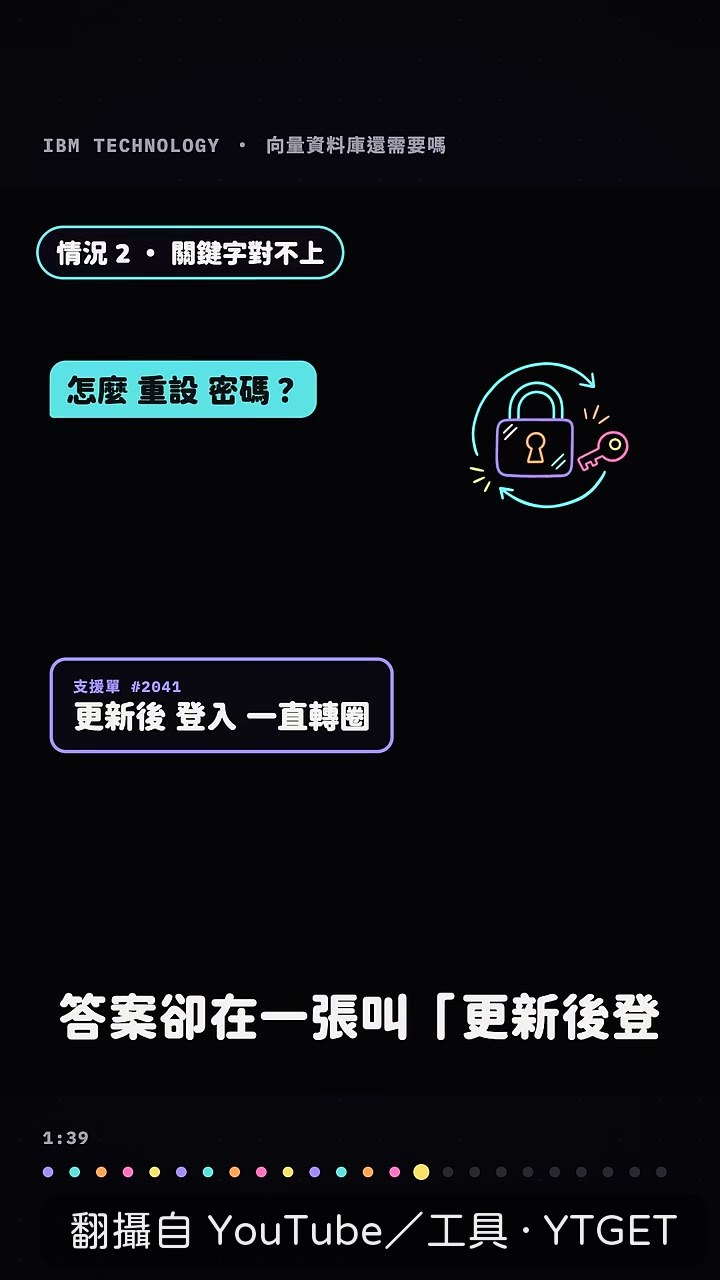
- 01:36用「重設密碼」對上「更新後登入卡頓」的工單,說明語意落差
- 02:00講到百萬向量、頻繁查詢時標準資料庫會撐不住
- 02:36收尾要你回頭看自己的資料在金字塔哪一層
AI 自己換詞搜,聽起來很萬能
Martin Keen 說自主運行的 AI 可以拿搜尋工具一直換詞試,像尋寶一樣總會找到。這段我覺得是最容易被誤解的地方,換詞有效的前提是你大概知道答案長什麼樣,詞彙空間有限才玩得起來。真的資料一多、用詞一歪,它照樣兩手一空。
上下文變大不代表可以無腦全塞
他說 AI 的閱讀能力是幾年前的 1000 倍,所以全部丟進去也行。但後面自己補了一句:資料量龐大時全塞又貴又不準,像揹包塞爆找不到課本。這兩句放在一起其實在打臉「長上下文萬能」的說法,只是語氣很輕。
「重設密碼」對上「登入一直轉圈」
這段才是整支片的重點。你問密碼,答案卻在一張叫「更新後登入卡頓」的工單裡,一個字都沒對上,關鍵字搜尋直接漏掉。Martin Keen 說這就叫語意落差,意思相同、用詞不同,這時候才值得在原本的資料庫加向量索引,不是另外架一套。
兩個問題決定你要不要爬上去
收尾給的判斷很乾脆:需要按意義搜尋嗎?數量夠大、需要專門的倉庫嗎?內容少就全放進去,關鍵字夠用就用關鍵字,意思對不上才加向量,資料量真的爆炸才碰專用向量資料庫。這種「先問再買」的順序,比直接叫你選邊站實用。
值得下載嗎:值得,兩分半把判斷順序講完,沒有硬推哪一派。如果你正在猶豫要不要為專案加向量資料庫,留著當決策清單剛好。
覺得這篇筆記有幫助嗎?