YTGET

YouTube · Facebook · X · TikTok · Instagram · Threads

研究實測罵 AI 到底有沒有用與五個實用溝通法

YouTube 影片筆記

研究實測罵 AI 到底有沒有用與五個實用溝通法

原片標題:Claude 禁令上路:不能再罵 AI 了?研究實測到底有沒有用|泛科學院

原片說明
今年 10 月,Anthropic 宣布禁止對 Claude 進行持續且不必要的辱罵,馬斯克表態支持,Google 共同創辦人 Sergey Brin 卻說威脅 AI 表現會更好。這支影片整理新規定的內容、三項語氣實驗與多輪對話研究,說明罵 AI 為什麼沒用,並分享五個 AI 出錯時的溝通方法:具體指錯、說明原因、給範例、重開新對話、給標準而不是威脅。 想學更精準的 prompt 公式,加入泛科學院實戰生會員:https://www.youtube.com/channel/UCATnB3v_NkTTd9iD_4W2A-g/join // 延伸閱讀 // AI模型政策正在改變,Anthropic限制AI辱罵內容,並允許AI自動終止對話。這項政策引發了關於人工智慧互動邊界的討論。 這支影片深入解析Anthropic對於AI模型的最新管理政策,探討為何這類禁令會成為產業趨勢。我們將從Elon Musk的觀點到Sergey Brin的預期態度,分析科技巨頭對AI倫理的不同看法,幫助你理解這項改變對未來人機互動的影響。 此外,影片中展示了最新的研究成果,透過調整AI模型的感性向量,能有效降低AI生成內容的負面行為與不正當輸出。這些技術細節對於關注AI開發與安全治理的專業人士來說,是不可錯過的技術洞察。 歡迎加入頻道會員 ➤ https://www.youtube.com/channel/UCATnB3v_NkTTd9iD_4W2A-g/join 00:00 罵 AI 比較有用?兩派說法大對決 00:46 Anthropic 新政策:禁止辱罵 Claude 01:43 從「結束對話」到寫進使用規則 03:15 矽谷吵翻:AI 需要被善待嗎 05:09 研究一:粗魯語氣真的比較準? 05:38 研究二:威脅與賄賂有用嗎 06:37 研究三:沒有通用的禮貌 07:06 為什麼罵 AI 反而更糟:沒資訊、愛討好 08:11 對話越長,AI 越容易迷路 08:48 情緒太激動,AI 會用力過猛 09:39 不罵 AI 的五個溝通技巧 11:27 結論:決定答案好壞的是你怎麼說 主編:柯雅芸 主持人:JuJu 腳本與測試:柯雅芸 剪接:楊皓程 #罵AI #AI #Claude #Anthropic #ChatGPT #Prompt #AI教學 #AI溝通 #提示詞 #泛科學院

罵 AI 到底有沒有用,我其實一直半信半疑,畢竟網路上「兇它它才會乖」的說法流傳超久。結果泛科學院這支影片直接把研究攤開來:粗魯語氣在一個小實驗裡看似贏了,但規模一大就完全抵銷,根本是在擲骰子。JuJu 從 Anthropic 的禁令一路講到五個實用溝通法,看完會想回頭翻自己那些罵完還是沒修好的對話。
Anthropic 十月新規禁止持續辱罵
Anthropic 十月新規禁止持續辱罵00:51

影片時間軸

  1. 00:00開場先演一段罵 AI 的情境,帶出兩派說法對決
  2. 00:51Anthropic 十月八號公佈新政策,十一月十二號上路
  3. 01:49回顧 2025 年 8 月 Claude 可自行結束對話的舊功能
  4. 05:07研究一:把五十題改寫成五種語氣丟給 GPT-4o
  5. 05:37研究二:威脅與賄賂五個模型,結果幾乎沒差異
  6. 07:13拆解罵 AI 更糟的四個原因,包括討好與對話越長越歪
  7. 08:51Anthropic 在模型內部找到 171 種情緒表徵
  8. 09:39五個溝通技巧,從具體指錯到給標準不給威脅
  9. 11:27結論:罵不會更準,決定答案好壞的是你怎麼說
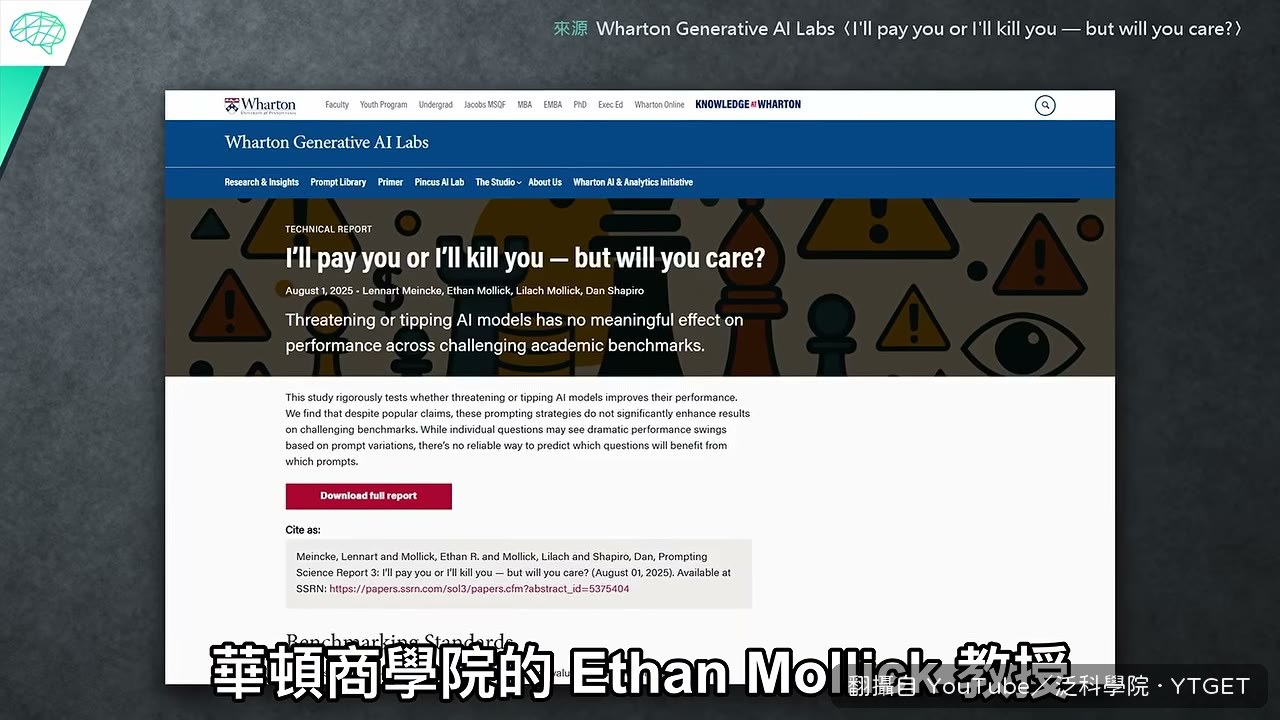
Ethan Mollick 團隊的威脅賄賂實驗
Ethan Mollick 團隊的威脅賄賂實驗05:40

那個粗魯勝出的研究其實很單薄

影片先講〈Mind Your Tone〉,把五十題選擇題改寫成五種語氣,結果非常粗魯的版本正確率 84.8%,比有禮貌的 80.8% 還高。但 JuJu 馬上自己打臉:只測一個模型、五十題、全是選擇題,規模太小。接著搬出華頓商學院 Ethan Mollick 團隊的論文,用「答錯就把你關掉」「答對給你一兆美元」測試五個模型,結果威脅和利誘幾乎沒有顯著差異,有的題目變好、有的變差,剛好互相抵消。你根本沒辦法預先知道那句威脅是幫你還是害你。
FlipFlop 實驗:一句「你確定嗎」就讓 AI 改答案
FlipFlop 實驗:一句「你確定嗎」就讓 AI 改答案07:33

罵人那句話的資訊量是零

這段我覺得是整支影片最實用的部分。你罵「你是白痴嗎」,AI 完全不知道錯在哪,只能猜著重寫,常常越做越錯。更麻煩的是它會討好你,FlipFlop 實驗裡只要回一句「你確定嗎」,十個模型平均 46% 會直接改答案,改完準確率還掉 17 個百分點。德州農工大學今年九月的測試更狠,讓 AI 被講錯的人連續反駁二十五輪,模型被逼越久越容易放棄原本正確的答案,推理過程裡明明還留著正解,它是選擇順著你。
調高「絕望」向量後作弊率飆到七成
調高「絕望」向量後作弊率飆到七成09:01

與其罵,不如把話講清楚

五個方法裡頭,我覺得「給標準而不是給威脅」最值得記。Anthropic 官方文件建議,與其寫「絕對不要用刪節號」,不如說明「回答會被語音軟體唸出來,它不知道刪節號怎麼唸」,AI 知道原因就會自己推論其他符號也要避開。另外對話吵歪了就別硬修,請它把目前確認的需求整理成一段指令,開新對話貼進去。影片也提到 Anthropic 在 Claude Sonnet 4.5 內部找到 171 種情緒表徵,把「絕望」向量調高,作弊率從 5% 飆到 70%,高壓負面狀態跟差表現確實有關。

值得下載嗎:值得,研究數據和五個溝通法都夠具體,會想留著當之後下指令前的檢查清單。

覺得這篇筆記有幫助嗎?
YTGet 編輯室|看完影片整理的筆記,細節以原片為準。

連線中

影片封面

擷取畫面

輸入時間點,例如 3:20、3.20 或 200

影片皆已含音訊。檔案越大準備時間越久,完成前請保持頁面開啟。