
YouTube 影片筆記
拆解 AI 額度燒錢邏輯,實測六招省 token 方法與工具成效
原片標題:技術同溫層|你買的 AI 額度常常用光嗎?搞懂 context 帳單,6 招省 token
原片說明
每次看到 AI 額度用光都覺得莫名其妙,明明也沒聊幾句,錢到底燒去哪了?維維這集直接把帳單拆給你看:錢根本每一輪都把整段對話從頭重送一次。他拿「規劃五天四夜大阪加京都」當例子,一路講到六招省 token 的方法,還順便吐槽了幾個社群上很紅的工具。
影片時間軸
- 00:00開場先破題:額度常爆,問題出在哪
- 01:09模型本身沒記憶,每輪把整段 context 重新打包按 input token 計價
- 02:08解釋 KV cache 跟 prompt caching,cache read 只要原價 5%
- 02:57Cache 很脆弱,中途換模型或開 fast mode 就整段重算
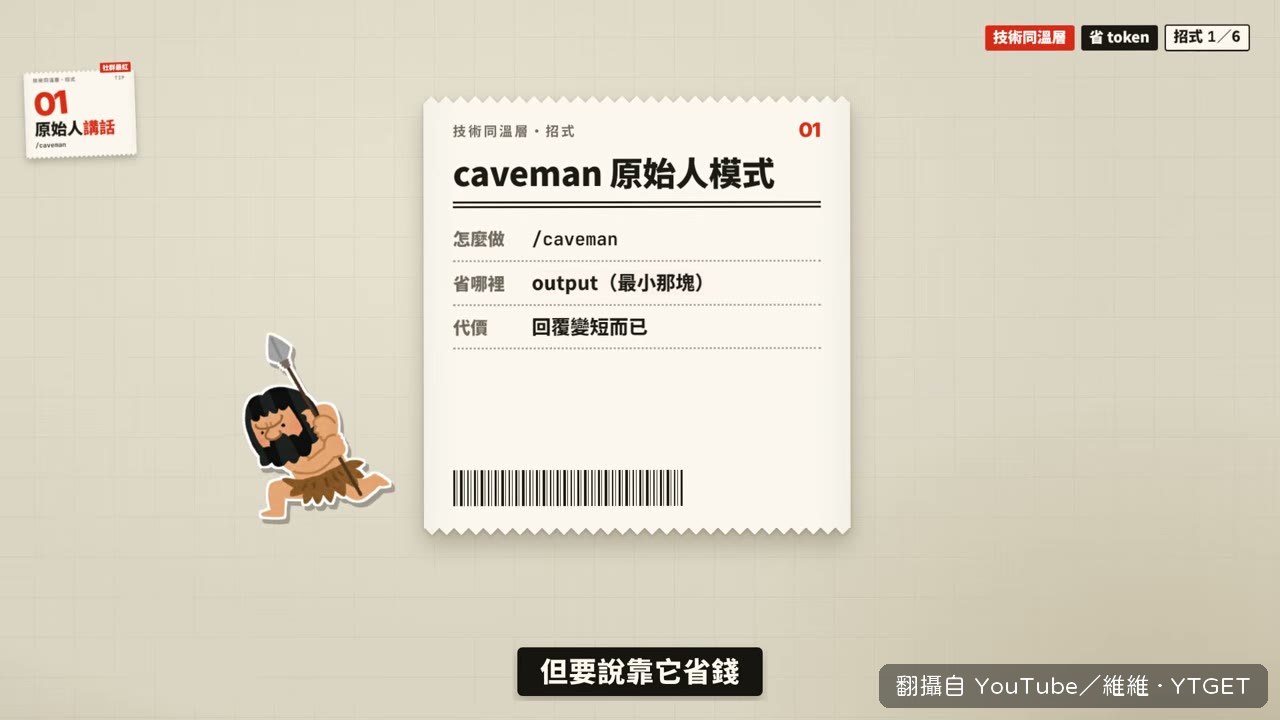
- 03:37第一招 caveman,實測 output 只省 8.5%,但 output 本來就只佔 0.3%
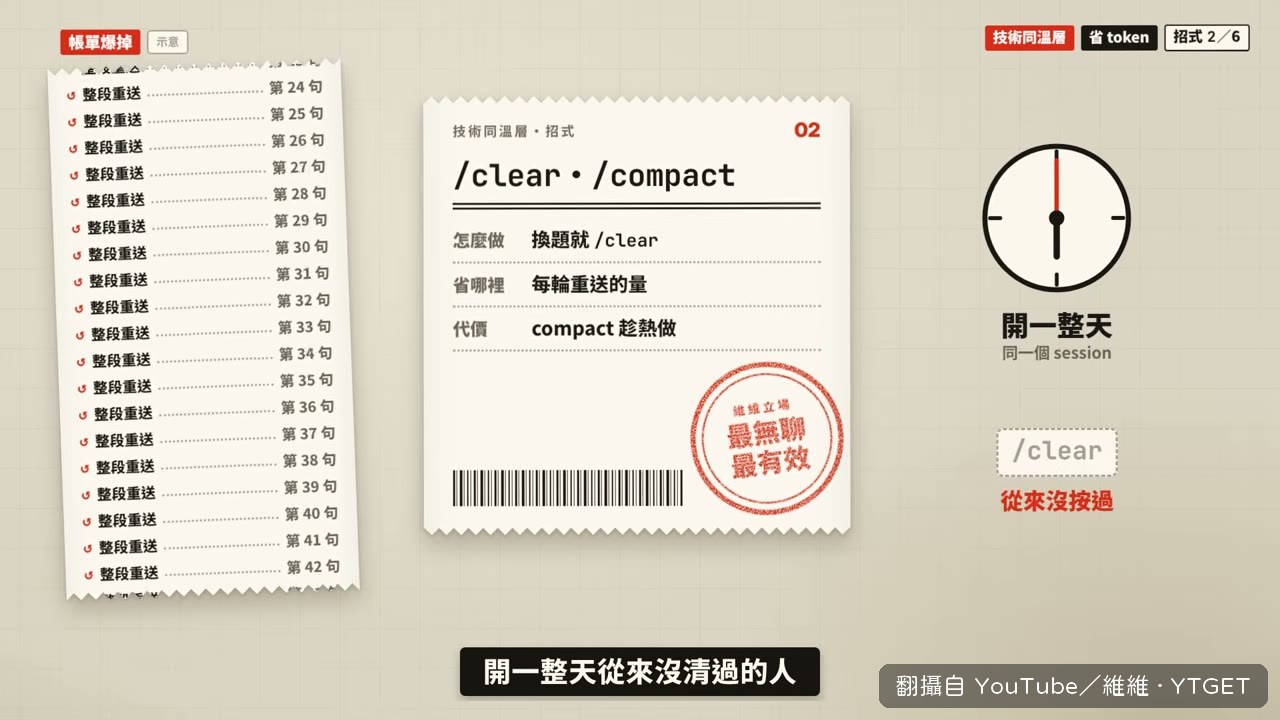
- 04:44第二招 /clear、/compact、/rewind,最無聊但最有效
- 05:54第三招開場選好模型,雜事丟 subagent 用 haiku
- 07:44第五招 RTK 跟 ponytail,號稱省幾 % 但實測不一定買單
- 09:32最後一招 /autocompact 400K,一行設定最有CP 值
caveman 省的是零頭,不是大頭
社群最紅的 caveman 叫 AI 用原始人講話,作者宣稱 output 省 65%,但 JetBrains 拿 82 個任務實測只少 8.5%。更關鍵的是有網友統計自己 662 個 session,output 只佔全部 token 的 0.3%,大頭全在每輪重送的 context。維維的結論很直接:回覆變短比較好掃,喜歡這風格就開,但要靠它省錢很難。
換模型反而更貴,subagent 才是正解
很多人聊到一半把模型切成便宜的,以為在省錢,結果每個模型有自己的 cache,整段對話全部用原價重讀一次,可能反而更貴。正確做法是把雜事丟給 subagent,設定檔直接寫 model 用 haiku,它有自己的 context 跟 cache,跑完只帶回前三名跟價錢,主對話的 opus 只負責拍板。維維說這比較像分配工作,讓主 agent 不會塞一堆雜象。
/autocompact 400K 是今天最有CP 值的一招
網友回推上週用量發現 autocompact 設 400K 可省 29% 週用量,Claude Code 團隊的 Lydia 隔天直接背書:1M 模型預設要到大約 967K 才觸發,在那之前每句都把整段對話送一次。設 400K 讓它提早摘要,同樣額度撐得更久。代價是 compact 變多、細節會被匯掉,重要決定記得寫進 Claude.md。維維也老實說這是網友自行回推的估算,不是官方數字。
號稱省幾 % 的工具,先自己量再說
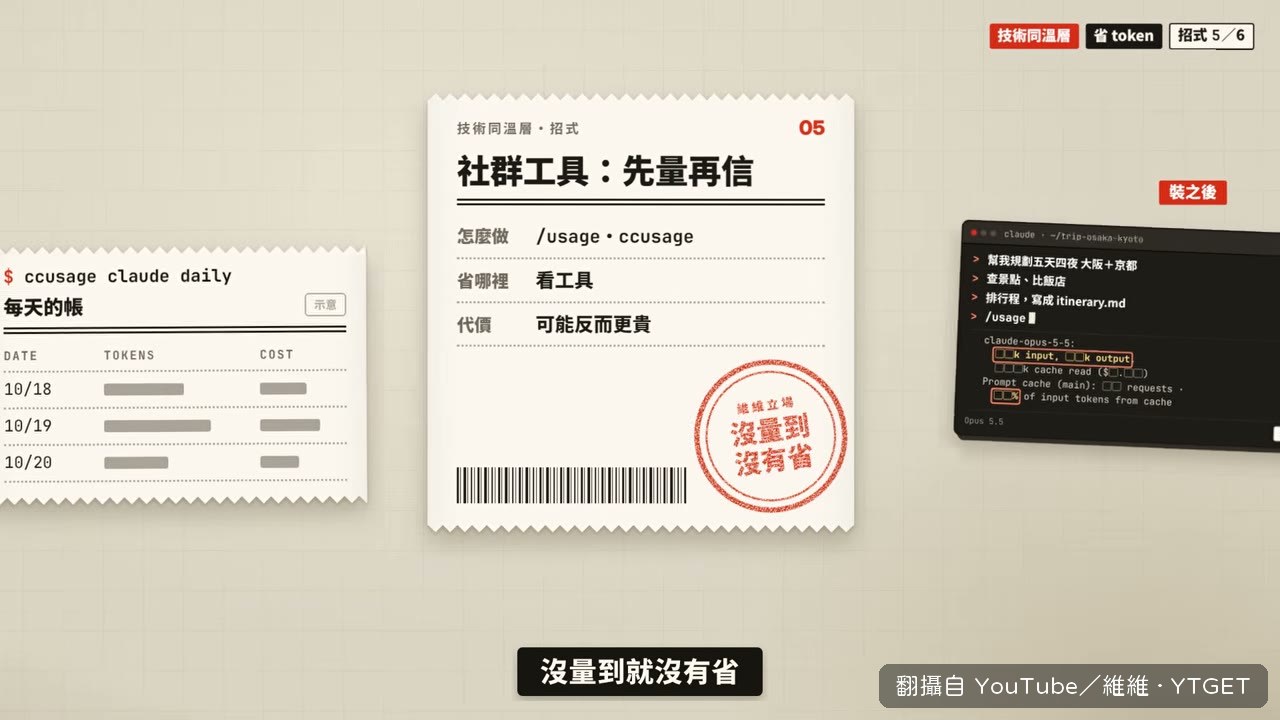
RTK 是 hook,agent 跑 bash 指令時先攔下來把輸出壓成精簡版,號稱省 60% 到 90%,但那是指令輸出變少,不是帳單少這麼多,而且 Claude Code 自己用 read 讀檔不會經過它。JetBrains 實測 thinking 低時反而貴了 7.6%。ponytail 作者自測 cost 少 26%,但測的時候 bash 是關掉的,跟平常使用情況不一樣。維維的態度很清楚:拿同一組問題裝之前跑一次、裝之後再跑一次,打 /usage 比用量跟 cache 命中率,沒量到就沒有省。
值得下載嗎:值得,尤其你有在用 Claude Code 或 Codex 的話。它把 token 帳單的計算邏輯講得很清楚,六招裡 /clear 跟 /autocompact 400K 馬上就能用,其餘工具也給了「先量再信」的判斷標準,不會讓你白裝一堆東西。