
YouTube 影片筆記
用 ComfyUI 與 Claude Code 在地端打造 AI 數字人的完整流程示範
原片標題:我是怎么做出来的?AI 数字人全流程:脸、声音、开口说话|开源模型本地跑
原片說明
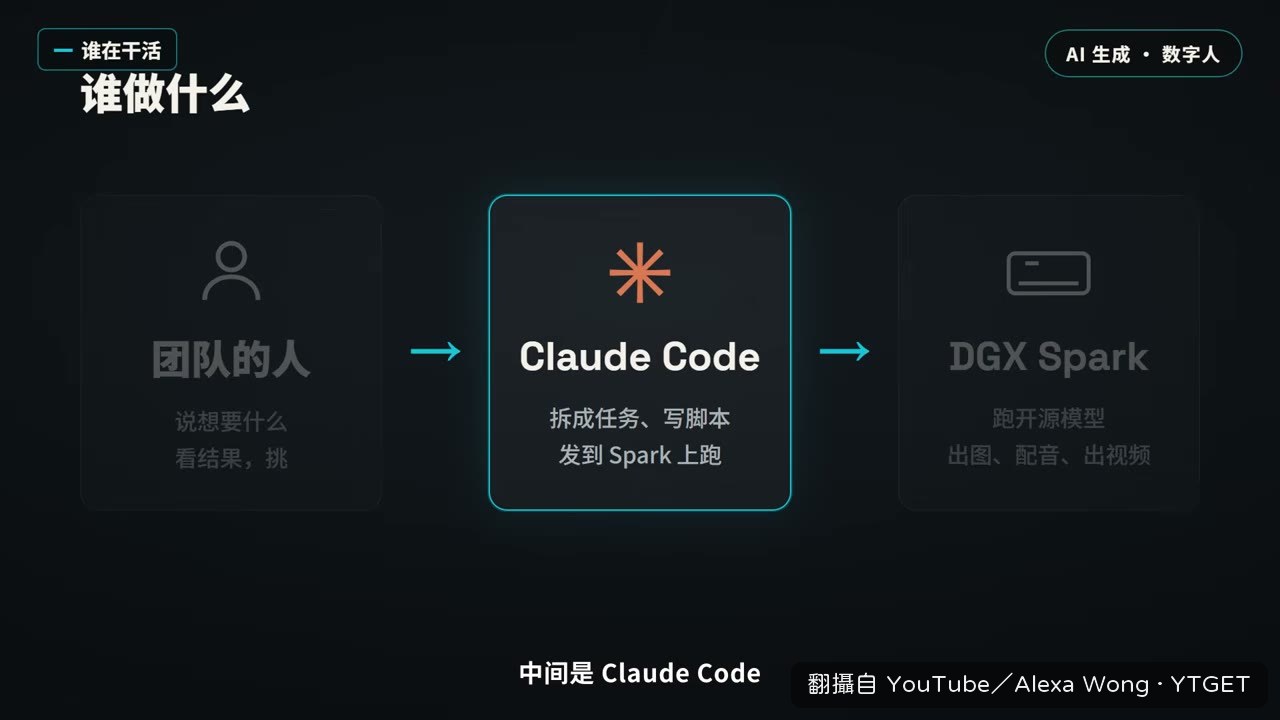
AI 数字人王渔鱼是怎么做出来的:脸、声音、开口说话,每一步用的软件和模型都在这期里。全部用开源模型,在一台 DGX Spark 上本地生成,人通过 Claude Code 指挥整个过程。模型不按次付费,Claude Code 是付费订阅。
上一期:https://www.youtube.com/watch?v=jbGZmQ7aktI
⏱ 章节
0:00 开场
0:30 一 · 谁在干活:人、Claude Code、DGX Spark
1:07 二 · 为什么全在本地做
1:32 三 · ComfyUI 怎么用
3:21 四 · 做出一张脸
4:41 五 · 做出一副声音
5:59 六 · 让照片开口说话
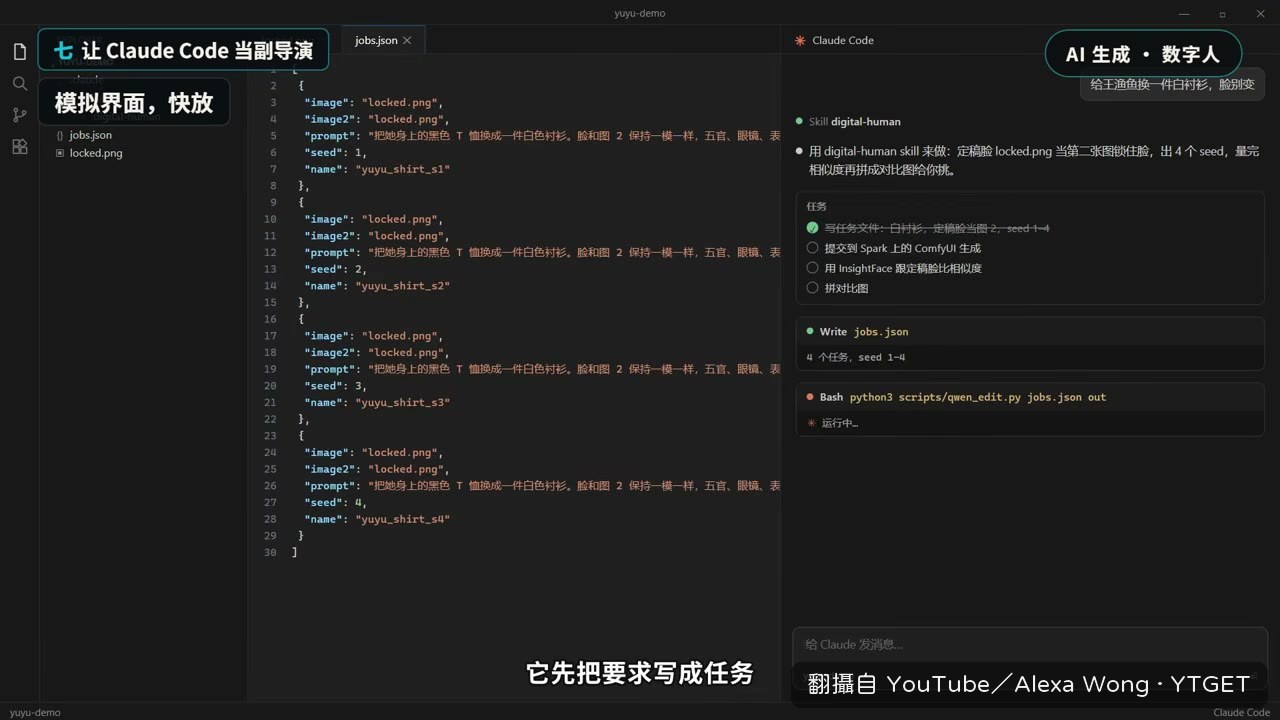
7:05 七 · 让 Claude Code 当副导演
8:36 八 · 要什么电脑,花多少钱
🧰 数字人制作 skill(这期第七章讲的,放进 Claude Code 的 skills 文件夹就能用):https://github.com/builder2ai/builder2-digital-human
🛠 工具(按在哪里跑分三组)
▶ 指挥:Claude Code(Anthropic 的 AI 编程助手)
https://www.claude.com/product/claude-code
VS Code 插件:https://marketplace.visualstudio.com/items?itemName=anthropic.claude-code
文档:https://code.claude.com/docs/en/overview
▶ ComfyUI 里:做脸、做说话视频
ComfyUI(开源的节点式 AI 工作台)
下载:https://www.comfy.org/download
GitHub:https://github.com/Comfy-Org/ComfyUI
插件管理器:https://github.com/Comfy-Org/ComfyUI-Manager
🧑 做脸:Qwen-Image-Edit-2511(阿里通义千问)
https://huggingface.co/Qwen/Qwen-Image-Edit-2511
看图读字的模型 Qwen2.5-VL:https://huggingface.co/Qwen/Qwen2.5-VL-7B-Instruct
(2026 年 9 月新出的 Qwen-Image 2.1 换成了更新的 Qwen3-VL,许可证也改成了研究许可;这期用的是 Apache 2.0 许可、可以商用的 2511。)
我们用的文件(放进 ComfyUI/models 下对应的文件夹):
・diffusion_models:qwen_image_edit_2511_int8_convrot.safetensors
https://huggingface.co/Comfy-Org/Qwen-Image-Edit_ComfyUI/tree/main/split_files/diffusion_models
・text_encoders:qwen_2.5_vl_7b_fp8_scaled.safetensors
https://huggingface.co/Comfy-Org/Qwen-Image_ComfyUI/tree/main/split_files/text_encoders
・vae:qwen_image_vae.safetensors
https://huggingface.co/Comfy-Org/Qwen-Image_ComfyUI/tree/main/split_files/vae
・loras:Qwen-Image-Edit-2511-Lightning-4steps-V1.0-bf16.safetensors(4 步提速)
https://huggingface.co/lightx2v/Qwen-Image-Edit-2511-Lightning
🗣 开口说话:InfiniteTalk(美团)+ Wan2.1(阿里通义万相)
InfiniteTalk:https://github.com/MeiGen-AI/InfiniteTalk
Wan2.1:https://github.com/Wan-Video/Wan2.1
WanVideoWrapper 插件(Kijai):https://github.com/kijai/ComfyUI-WanVideoWrapper
提速 LoRA:https://huggingface.co/lightx2v
我们用的文件:
・diffusion_models:Wan2_1-I2V-14B-480P_fp8_e4m3fn.safetensors、InfiniteTalk/Wan2_1-InfiniTetalk-Single_fp16.safetensors
・text_encoders:umt5-xxl-enc-bf16.safetensors
・vae:Wan2_1_VAE_bf16.safetensors
・loras:Lightx2v/lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors(4 步提速)
以上都在 https://huggingface.co/Kijai/WanVideo_comfy
・clip_vision:clip_vision_h.safetensors
https://huggingface.co/Comfy-Org/Wan_2.1_ComfyUI_repackaged/tree/main/split_files/clip_vision
・wav2vec2:wav2vec2-chinese-base_fp16.safetensors
https://huggingface.co/Kijai/wav2vec2_safetensors
原版(腾讯中文版):https://huggingface.co/TencentGameMate/chinese-wav2vec2-base
▶ ComfyUI 外:配音和检查(命令行里跑的小程序)
🎙 配音:Qwen3-TTS(阿里通义千问)
GitHub:https://github.com/QwenLM/Qwen3-TTS
在线试用:https://huggingface.co/spaces/Qwen/Qwen3-TTS
声音设计模型:https://huggingface.co/Qwen/Qwen3-TTS-12Hz-1.7B-VoiceDesign
克隆模型:https://huggingface.co/Qwen/Qwen3-TTS-12Hz-1.7B-Base
✅ 检查
脸像不像 InsightFace:https://github.com/deepinsight/insightface
声音是不是同一个人 CAM++(3D-Speaker):https://github.com/modelscope/3D-Speaker
字念没念错 Whisper:https://github.com/openai/whisper
💻 硬件
我们用的:NVIDIA DGX Spark 官方版|GB10 芯片,20 核 CPU,128 GB 内存(CPU 和显卡共用),4 TB 硬盘,Ubuntu 系统
https://www.nvidia.com/en-us/products/workstations/dgx-spark/
其他能用的电脑(我们没有实测,按官方和社区资料整理):
・同芯片的 GB10 机器,同样 128 GB 内存,流程可以照搬。华硕 Ascent GX10:https://www.asus.com/networking-iot-servers/desktop-ai-supercomputer/ultra-small-ai-supercomputers/asus-ascent-gx10/
戴尔 Pro Max with GB10、联想 ThinkStation PGX、惠普 ZGX Nano G1n 也是同一颗芯片,搜型号即可。
・英伟达显卡台式机,系统内存 64 GB 以上。兼容最好,算得比 Spark 快;说话视频要开 WanVideoWrapper 的 block swap,或者用压缩版模型。
RTX 5090(32 GB):https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
RTX 4090(24 GB):https://www.nvidia.com/en-us/geforce/graphics-cards/40-series/rtx-4090/
・Mac:Mac Studio M5 Max(最高 128 GB)、M5 Ultra(96 GB 起)。配音能跑,做脸能跑但慢,说话视频目前没找到在 Mac 上跑通的可靠记录。
https://www.apple.com/mac-studio/
Mac 上跑 Qwen3-TTS 可以看社区项目 mlx-audio:https://github.com/Blaizzy/mlx-audio
・手上没有合适的机器:可以先按小时租云端显卡试。
显存不够时:换压缩得更小的模型版本(fp8、GGUF),或
我本來以為「做一個 AI 數字人」是那種要排隊申請 API、按次計費的燒錢活,結果王魚魚根本是把整套流程搬回自己桌上跑。這支影片就是她把臉、聲音、開口說話三段拆開來,一個節點一個節點示範給你看。
影片時間軸
- 00:35畫面切成三塊:人、Claude Code、一台 DGX Spark 各司其職
- 01:41打開 ComfyUI 空畫布,解釋節點、連線、五段式工作流
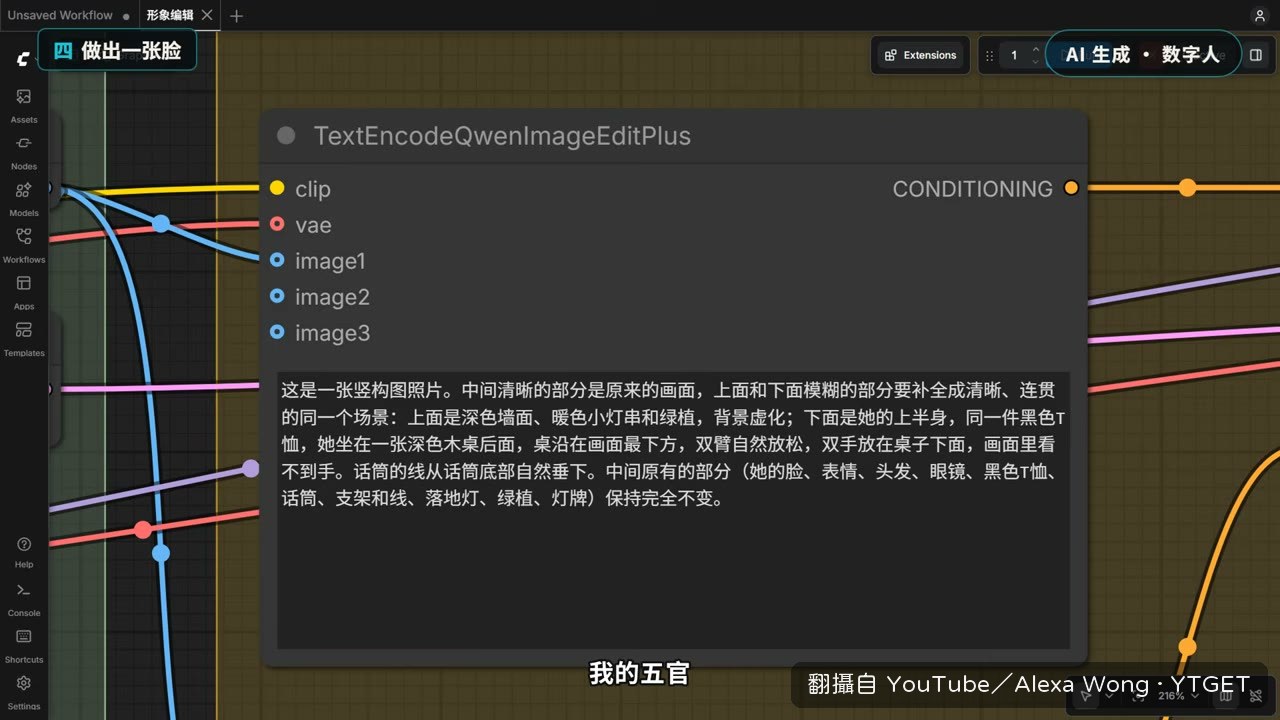
- 03:24用 Qwen Image Edit 一句一句改五官,寫出「更瘦的鵝蛋臉」
- 04:17換衣服臉會跑掉,改成每次把定稿臉當參考圖一起餵進去
- 04:44聲音改用 Qwen3 TTS,先文字描述造聲,再調音高共鳴
- 05:35配好的音過兩道檢查:CAM++ 驗聲紋、Whisper 抓唸錯的字
- 06:02InfiniteTalk 接手,給底稿影片讓頭自然晃、嘴跟著聲音動
- 08:39結尾算帳:模型檔 60 多 G,機器官方定價 4000 多美元
換衣服不會換掉那張臉
這段是我覺得整支影片最實用的一段。王魚魚直接點出痛點:每改一次圖,模型會整張重畫,臉也跟著飄,改三次就不像同一個人了。解法很具體,把定稿那張臉當第二張參考圖一起餵進去,要求裡寫明「臉和參考圖保持一模一樣」,出圖後再用 insightface 打分,低了就重來。這不是概念,是可以照抄的操作。
Claude Code 才是真正的副導演
ComfyUI 介面看起來一堆東西要調,但王魚魚說實際幹活時全交給 Claude Code:它把工作流寫成代碼發到 Spark 上跑,跑完自己先量一遍、拼成對比圖再交人挑。後面示範「給王魚魚換一件白襯衫,臉別變」,一次出四張,相似度都在 0.97 左右。整套流程還打包成 skill,放進資料夾就能用。
值得下載嗎
值得,尤其你想自己動手做數字人的話。它把每一步用什麼模型、卡在哪、怎麼解都講清楚了,還附 skill 和模型清單,是那種會想存下來邊做邊看的影片。
覺得這篇筆記有幫助嗎?