
YouTube 影片筆記
一隻騎車鵜鶘如何戳破AI跑分與參數迷思
原片標題:一只鹈鹕,怎么成了全球顶级AI的噩梦?
原片說明
一只骑自行车的鹈鹕,为什么成了全球大模型的必考题?今天咱们聊聊民间 AI 测试的走红与失效,为什么跑分越来越难代表真实能力?以及普通人到底该怎么判断 AI 好不好用?
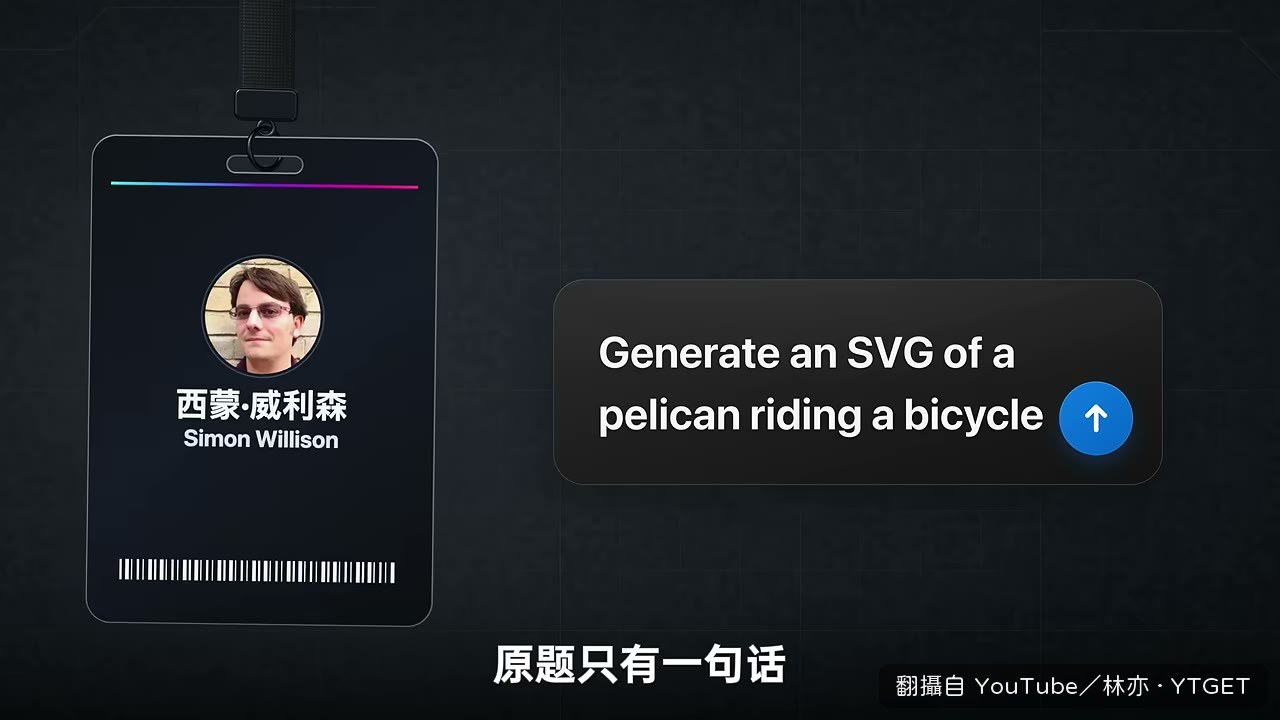
一隻騎腳踏車的鵜鶘,居然能讓全球最頂尖的 AI 集體翻車,也太荒謬了吧。更好笑的是,這題原本只是英國程式設計師西蒙想防止模型背題而隨手出的考題,結果現在變成新模型發表時的固定驗收項目,連 Jeff Dean 都拿它來宣傳。林亦這支影片就在講這隻鵜鶘怎麼從一道考題變成 AI 圈的迷因,以及它為什麼越來越測不準。
影片時間軸
- 00:25西蒙只給一句指令,要 AI 畫出騎腳踏車的鵜鶘
- 01:03模型得直接寫 SVG 原始碼,看不見畫布只能靠座標硬算
- 01:33西蒙拿新旗艦跟筆電跑的開源小模型對比,旗艦反而畫得更差
- 02:08開發者把八種動物配六種交通工具湊成四十八道題連測三輪
- 03:29回顧更早的民間考題,從 9.9 和 9.11 誰比較大到草莓有幾個 r
- 04:14洗車店距離家五十米,模型認真算油耗跟引擎磨損後建議走路
- 05:01經典測試集題目在網路上流傳多年,模型訓練時早就背下來
- 06:49同一顆模型不套智慧體外殼只拿三成,套上之後直接滿分
開源小模型反過來贏過旗艦
今年四月西蒙貼出一組對比,一邊是新發布的重裝旗艦,另一邊是他自己在筆電上跑的輕量開源模型,結果參數量大好幾個數量級的旗艦,畫出來的效果反而差了不少。西蒙當場懷疑對方是不是針對這道題特訓過,馬上換成鵜鶘騎獨輪車再考一次,結果還是開源模型更合他心意。這段最有意思的地方在於,它直接戳破「參數越大越強」的直覺。
跑分榜單早就不能信了
林亦把原因講得很清楚:MMLU 這類經典測試集公開五六年,題目答案在網路上流傳,模型訓練時免不了背下來,跑出虛高的分數。更麻煩的是考卷本身同質化嚴重,看似考了十門課,其實翻來覆去測的都是同一塊能力。到了智慧體時代,有沒有套上駕馭工程的外殼,分數可以從三成跳到滿分,靜態考卷根本跟不上實戰。
值得下載嗎
值得。林亦把一隻鵜鶘怎麼變成 AI 圈共同語言講得又清楚又好看,還點出跑分失靈這個真問題,十分鐘換一個能拿去跟人聊的判斷框架,很划算。
覺得這篇筆記有幫助嗎?