
YouTube 影片筆記
M5、M6 Mac 跑本地AI:預填充解碼與KV快取差異解析
原片標題:M5、M6 Mac 如何選? Mac 跑本地 AI:模型裝得下,為什麼跑Agent就想退貨?
原片說明
【補充與勘誤】感謝留言指正,以下幾處需要補充。
1. 記憶體:
片中「規格表上的記憶體數字就是模型可以用的量」, 實際當然還要扣掉macOS 本身的佔用與工作緩衝區, KV cache 和其他程式都會占用.
2. 補充MLX
雖然MLX 和 MoE 是不同層次.
但優化處確實要提一下MLX, 它是 Apple 推出的開源機器學習框架, 針對 Apple silicon 調校並利用統一記憶體架構.
MoE 則是模型架構.
相容的 Dense 與 MoE 模型都可以透過 MLX 執行, MLX Community 也提供許多已轉換或量化的版本.
官方註明, 若要由 MLX 利用 M5 GPU 裡的 Neural Accelerators, 需要 macOS 26.2 或更新版本. 這是 M5 的 MLX 加速條件, 不是所有 Mac 本地推論軟體的通用版本要求.
3. 15:16「把兩台接起來」是什麼意思
那段講得太快.
原始來源:https://blog.exolabs.net/nvidia-dgx-spark/
做法叫 disaggregated prefill/decode(預填充與解碼分離):由 DGXSpark 負責讀完整段輸入,算完後把 KV cache 透過 10GbE 網路逐層傳給 MacStudio,再由 Mac負責逐字生成.
等於讓算力強的那台做算力的活,讓頻寬高的那台做頻寬的活.
完整條件:Llama 3.1 8B FP16、8,192 token 輸入、生成 32 個token, 1.47 + 0.85 = 2.32 秒, 對比 M3 Ultra 單機 6.42 秒約 2.8 倍.
這是 EXO Labs 自家測試,不是第三方獨立驗證.
同一台 Mac,拿來聊天很快,拿來跑 Agent 卻慢到想退貨。兩個感覺都是真的,因為你用到的是它身上兩個不同的規格。這支影片把買 M5、M6 Mac 之前該懂的三件事講清楚:記憶體決定你裝不裝得下、頻寬決定吐字多快、算力決定你按下送出之後要等多久。然後分成三種人給出對應的機型與價格級距,你拿自己的使用情境去對就好。
影片章節
0:00 到底要買哪一台
0:57 你按下送出之後, 機器在做什麼
3:09 我點下去才發現選不了
3:52 Mac 在預填充上一直是弱的
7:03 聊天很快, 跑 Agent 卻很慢
8:44 MoE 這類模型剛好補在 Mac 的痛點上
10:50 三種人, 三個規格
13:26 主要拿來生影片的話, 建議別買
14:59 有人把 DGX Spark 和 Mac Studio 接起來
16:07 你卡在哪一件事, 就看規格表哪一行
三個規格各自卡住你什麼
記憶體:決定模型裝不裝得下。Mac 是統一記憶體, CPU 跟 GPU 共用同一池, 所以規格表上那個數字就是模型能用的量 —— 這是 Mac 跑大模型真正的優勢。
記憶體頻寬:決定吐字多快。每產生一個字都要把權重整份讀過一次, 頻寬翻倍, 吐字速度就接近翻倍。
算力:決定你按下送出之後要等多久。這一段吃的不是頻寬, 所以頻寬再高也救不了。
為什麼同一台機器有時候很快、有時候很慢
聊天是「輸入短、輸出長」, 你的體感由頻寬決定, 跑分表上的數字好看你就真的爽。
跑 Agent 是「讀進去一大坨、吐出來一小撮」, 時間幾乎全花在處理輸入, 不在吐字。
而且每開一個子代理就是一次全新的預填充, 開四個就是四次。
影片裡有一組同一台機器、同一個模型、只切一個開關的實測數字, 可以看出這兩件事真的是分開的。
三種人, 三個級距
AI 全部用雲端的:這些差別對你幾乎沒有意義, 十六到三十二 GB 都夠用。
要剪片、同時想在本地跑模型的:影片裡給了我認為的甜蜜點與理由。
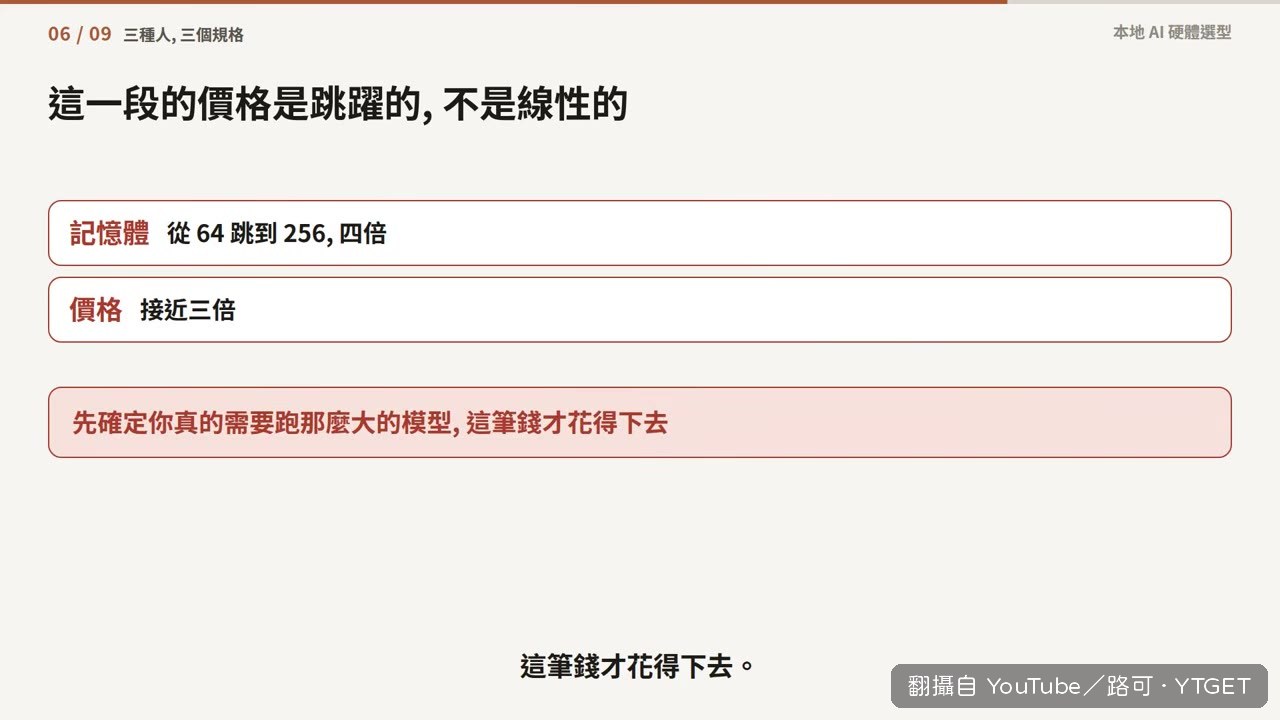
真的要跑那種很大的開源模型的:你要看的是另一個量級, 而那一段的價格是跳躍的, 不是線性的。
生圖跟生影片是另一回事, 影片裡單獨用一章講, 結論跟前面不一樣。
說在前面
這批機器九月二十二號才出貨, 所以片中還有一些位置是沒有第一批實測數字的, 我在影片裡都標出來了。
等實測出來我會回來把那些地方補上。
你現在卡在哪兩個規格之間, 或者已經下訂了哪一台, 留言告訴我你的用途, 我看看能不能幫你判斷。
訂閱路可
這裡分享各種 AI 知識與工具介紹。
覺得有幫助, 按個讚、訂閱、開鈴鐺。
我是路可, 讓我們一起踹踹看。
@trytrylook888
#MacStudio #Macmini #本地AI #AI工具 #路可
同一台 Mac,聊天快到像沒延遲,跑 Agent 卻慢到想退貨?兩個感覺都是真的,因為你用到的是它身上兩個不同的規格。這支影片把記憶體、頻寬、算力這三件事拆開講,看完你就知道該看規格表哪一行,也才知道 M5、M6 到底該買哪一台。
- 00:00開場:九月新 Mac 到底要買哪一台,官網規格越排越不確定
- 00:57解釋預填充與解碼:一個吃算力,一個吃記憶體頻寬
- 02:08KV cache 失效的三種情況,快取沒中要等八十二秒
- 03:09Mac 統一記憶體的優勢,以及記憶體選上去 GPU 被迫換顆的連動關係
- 03:52預填充是 Apple 弱點,M3 Ultra 跑長輸入也要等九十秒
- 05:03M5 的神經加速器讓預填充快三到四倍,但吐字速度幾乎沒動
- 08:50MoE 模型剛好補在 Mac 痛點上,名字裡有 A 的那種
- 10:50三種人對應三種規格:雲端派、剪片加跑模型、本地大模型重度需求
- 13:26生圖生影片在 Mac 上是弱的,主要目的建議直接考慮 NVIDIA
- 14:59有人把 DGX Spark 和 Mac Studio 接起來,兩台各贏一半
快取命中與否,差二十八倍
同一台 Mac、同一個模型,快取全中等兩點九秒,沒中要重算等八十二秒。差別只在前面那段輸入有沒有動過。如果你覺得 Mac 有時快有時慢,不是錯覺,是 KV cache 有沒有被沿用。開新子代理、工具結果插進中間、程式關掉重開,這三種情況都會讓快取全部失效。
MoE 是 Mac 的專武
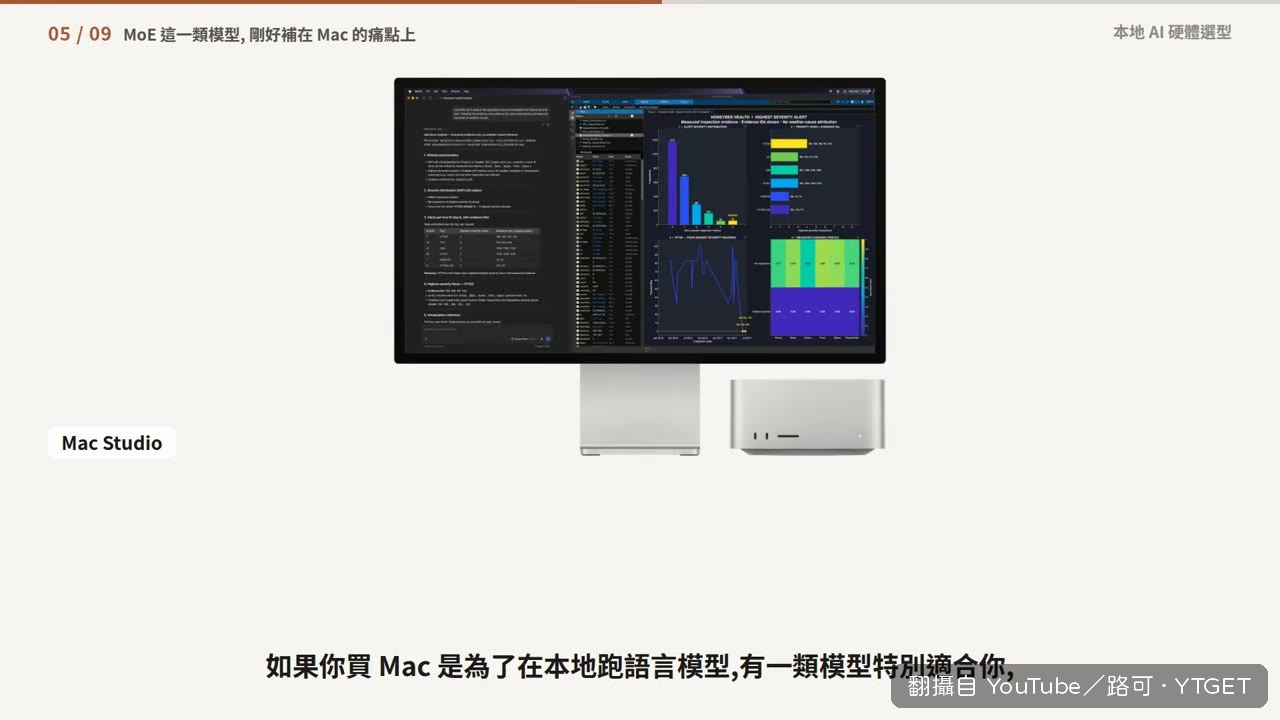
一般模型每次吐字,所有引數都要動一次。MoE 把運算層拆成幾十組,每次只叫醒兩三組,沒被叫到的還是佔記憶體,但不參與運算。Mac 強項是記憶體大、弱項是算力差,MoE 剛好兩邊都補上。所以同一台 Mac 跑一千一百七十億引數的 MoE,可以比跑七百億的一般模型還快。
生影片別指望 Mac
算力本來就是 Mac 弱項,加上沒有 TensorRT 那種等級的推論最佳化,ComfyUI 走 PyTorch 的 Metal 後端,有些運算沒實作還會掉回 CPU。M5 算力有改善,但中間隔著 PyTorch,新加的矩陣單元才剛開始支援。如果主要目的是生影片,建議直接考慮 NVIDIA,Mac 拿來當日常機順便掛著跑才划算。
值得下載嗎
值得。這支把預填充、解碼、KV cache、MoE 這些名詞跟規格表的對應關係講得很清楚,買 Mac 跑本地 AI 之前看這支,可以少走很多冤枉路。
覺得這篇筆記有幫助嗎?