
YouTube 影片筆記
Mac mini實測11款本地模型,跑得動與跑得順的差距一次看懂
原片標題:Qwen3.8 27B大火!实现Token自由?Mac mini实测11个本地模型,表现如何...
原片說明
最近Qwen3.8 27B大火,为什么它突然变成全AI爱好者热议的话题?到底要不要为了它升级设备、砸钱买硬件?我拿出手上最好的设备,实测了十多个本地模型的真实表现。结果让我有了不少新的想法,甚至想出一套"不上云"的折中方案。如果你也在纠结要不要折腾本地模型,或者想知道"模型自由"到底值不值得追,那这期内容,也许能帮你理清思路。
TuTu的网站:https://tutulifestyle.com (聚合了各类信息,包括linktree、哪里买的、经验分享、联系方式等)
欢迎加入TuTu的会员频道,感谢支持~ https://imtutu.com/vip
搬瓦工:https://imtutu.com/vps (搭建翻墙服务、网站服务、美国专线、Docker应用)
机场:https://imtutu.com/xipcloud (安全的翻墙机场,正在给家里的软路由使用这个)
输入法:https://imtutu.com/typeless (用的比较多的一个输入法,回评论和写稿效率很高)
TuTu的私信:https://imtutu.com/message
TuTu的群聊:https://imtutu.com/telegram
TuTu的联系邮箱:[email protected]
非常感谢你的支持(o^^o):https://imtutu.com/tiptutu
Qwen3.8 27B 紅成這樣,結果我自己手上這台 Mac mini 一跑,每秒不到 10 個 token,看到那個數字我直接笑出來。這支影片 TuTu 把 11 個本地模型全測了一遍,從跑得動的到跑不動的,還有他最後想出來的「不上雲」折中方案,看完你會知道到底該不該為了模型自由砸錢。
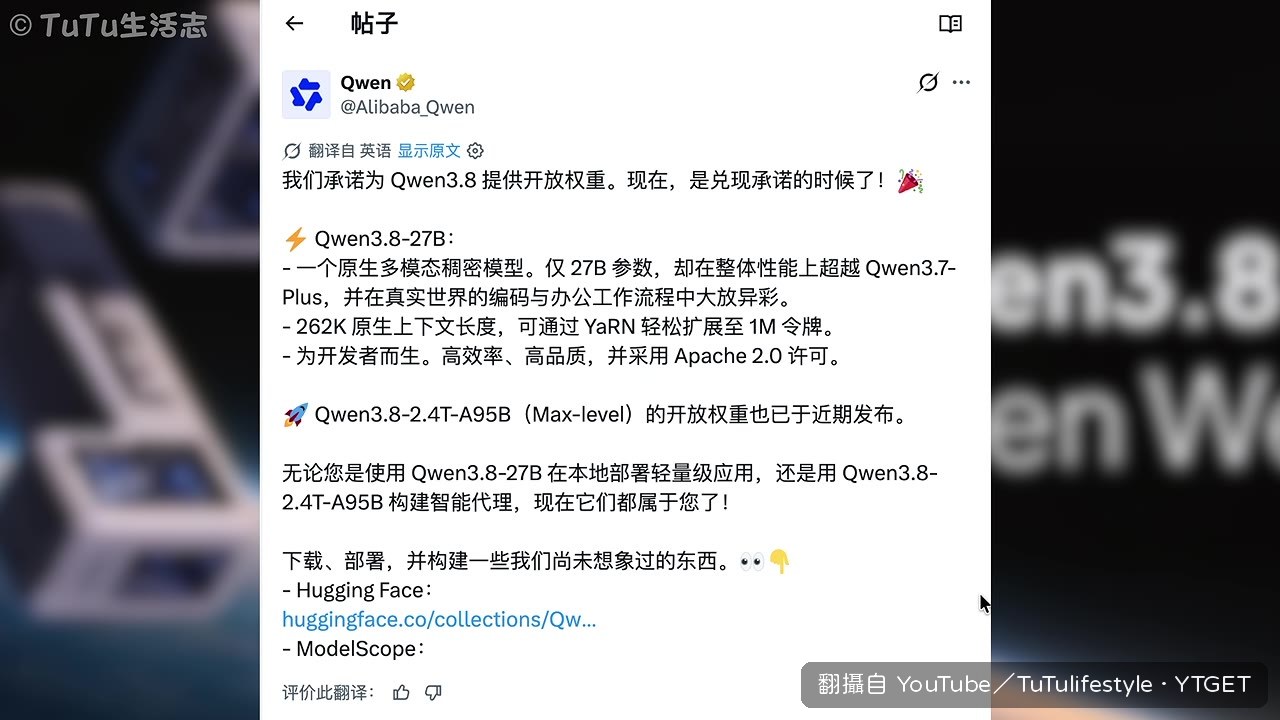
- 00:00開場解釋 Qwen3.8 27B 為什麼突然爆紅,三個原因:能力夠用、家用裝置能跑、開源版本齊
- 02:23拿出 2024 款 Mac mini,準備開始測 11 個本地模型
- 03:21Qwen3.6-35B-A3B 每秒 50 多個 token,TuTu 說這是他日常主力
- 03:43DeepSeek 32B 載入快 90 秒,一句打招呼等了十多分鐘,直接放棄
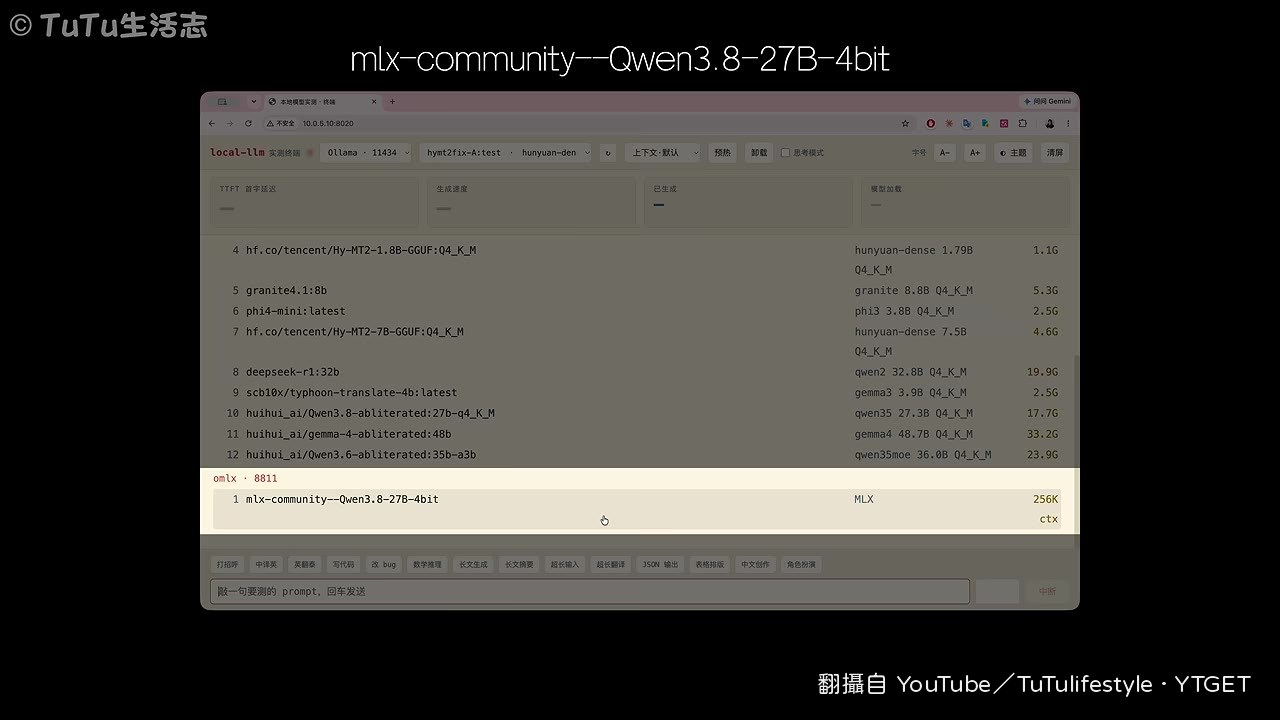
- 04:19分三次跑不同版本的 Qwen3.8 27B,最快每秒 15 個 token,延遲還是明顯
- 05:28Google 的 Gemma 模型每秒六七十個 token,日常用起來很順
- 07:03測最後一個泰語翻譯模型,TuTu 自己承認不懂泰語,品質無法判斷
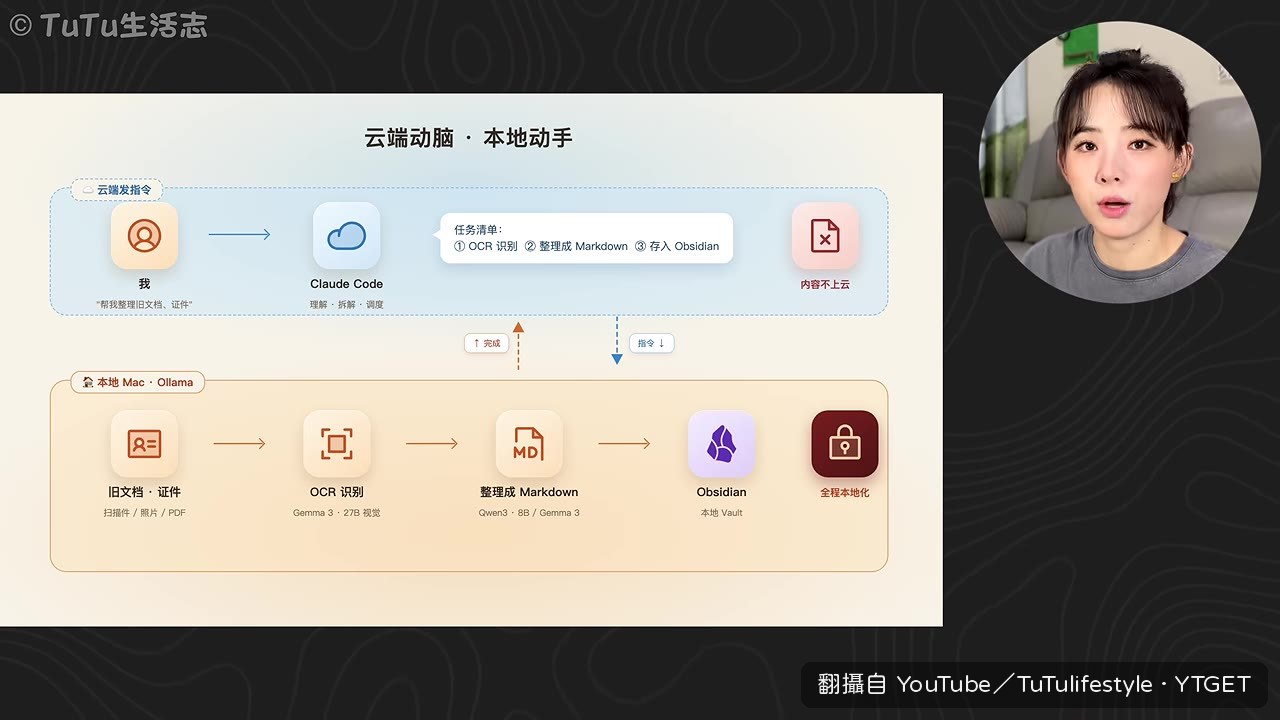
- 08:09分享折中方案:雲端 Claude 整理資料,指揮本地模型存入 Obsidian,兼顧聰明與不上雲
跑得動跟跑得順是兩回事
TuTu 測完之後說了一句很中肯的話:能跑不代表能投入實際使用。DeepSeek 32B 光是載入就快 90 秒,一句打招呼等十幾分鐘,這不是延遲,是直接不能用。Qwen3.8 27B 雖然是這次的主角,但在 Mac mini 上最快也就每秒 15 個 token,TuTu 說複雜任務「看著都覺得累」。反而是小模型像 Phi 3.8B 每秒 80 多個 token,跑起來毫無壓力,但能做的事就那麼多。
不上雲的折中方案才是重點
TuTu 最後分享的用法我覺得很實際:讓雲端 Claude 做 OCR 和整理,再指揮本地模型把資料存進 Obsidian。這樣主模型夠聰明,核心內容又不用上雲。他提到兩年前有人花十幾萬買機器搭離線環境,現在可能還不如幾台 Spark,所以他自己完全沒有硬體升級的衝動。這個觀望的態度,比那些叫你趕快砸錢買裝置的影片實在多了。
值得下載嗎
值得。如果你在猶豫要不要為了本地模型升級裝置,這支影片直接幫你省下幾萬塊的冤枉錢,實測資料和折中方案都給得很具體。
覺得這篇筆記有幫助嗎?