
YouTube 影片筆記
用巴菲特股東信實作 RAG:資料清洗、切塊到排查答錯的完整流程
原片標題:從零搞懂 RAG,要搭個人或企業知識庫必學!
原片說明
把巴菲特六十年的股東信全丟給 AI,結果直接被一句「檔案超過上限」打回來,這也太真實了吧。Gary 用這個例子把 RAG 講得很白話:先查、再回答。整支影片從資料清洗、切塊、貼標籤,一路講到混合搜尋和排查答錯的順序,基本上就是一份可以照著做的實作流程。
影片時間軸
- 01:34先叫 ChatGPT 扮演巴菲特,一開始講得頭頭是道
- 02:20把六十年股東信打包丟進去,直接撞上 Context Window 上限
- 03:51點出 RAG 的核心:只把真正用得上的那兩三段找出來給 AI
- 05:31清洗資料的兩個目標:拉高資訊密度、確保語意獨立
- 06:47用便宜小模型做代名詞還原,把「它」換回可口可樂
- 07:40固定字數切塊的硬傷:一句話被腰斬,卡片單獨看不知所云
- 10:21每張卡片貼 Metadata,用年份和出處先做條件過濾
- 13:27關鍵字搜尋加語意搜尋並行,也就是混合搜尋
- 14:58用 Re-ranking 把二十張候選重新排名,挑出真正有用的
- 17:56用「哪一年買下喜詩糖果」示範照 R、A、G 順序排查
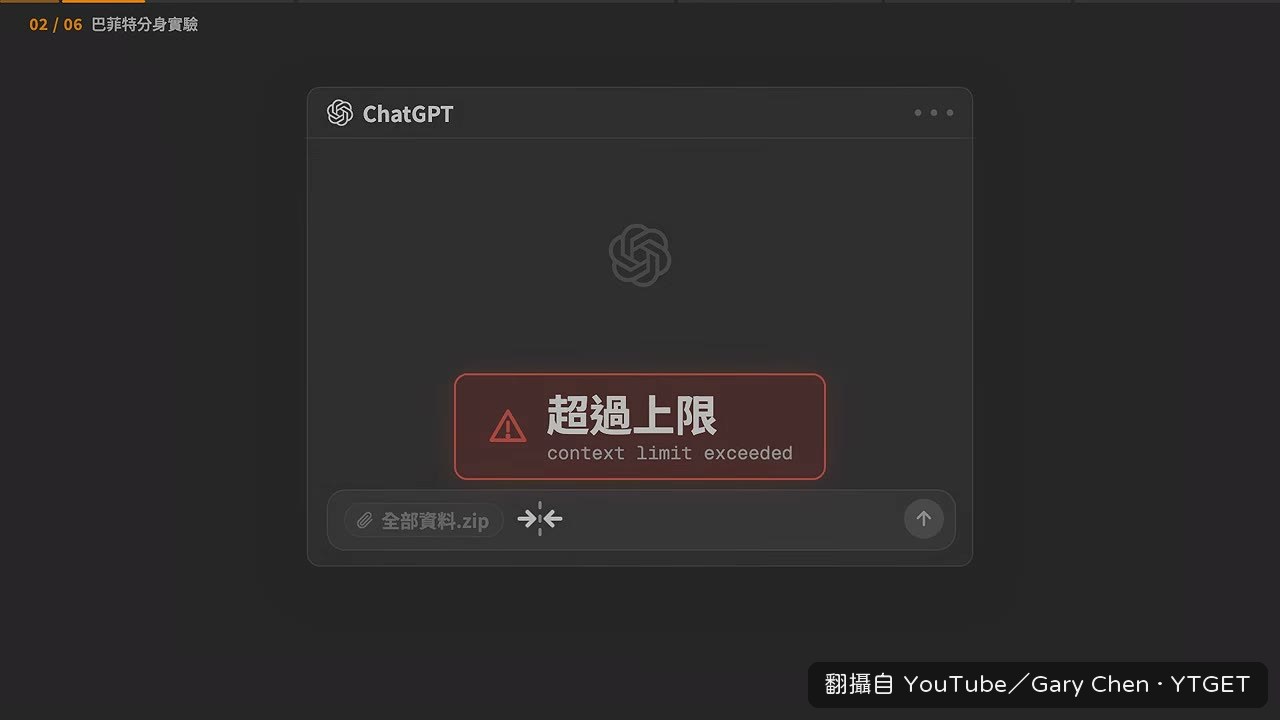
先叫 AI 演巴菲特,再被檔案上限打臉
開場那個「請扮演股神巴菲特」的提示詞,大概很多人都試過。Gary 沒有停在這裡,而是往下推:資料一多,模型根本記不住你餵過什麼,每問一題就重讀一次,又慢又貴。這段把痛點鋪得很清楚,後面談 RAG 才有著力點。真正關鍵的一句是,你問護城河,用得上的內容往往只有那兩三段,那何必逼 AI 從頭啃到尾。
清洗資料比挑向量資料庫重要
Gary 說很多人第一步就跳去挑資料庫、寫檢索演算法,但找不到答案的根源九成在資料本身。他講的清洗把頁首頁尾、主持人寒暄、現場笑聲這些雜訊剔掉,再用小模型把「它那時候很便宜」還原成可口可樂,順便把誰問誰答標清楚。這段是整支影片最實用的地方,因為它講的是多數人會偷懶跳過的那一步。
切塊切壞,後面全部白做
固定字數切塊那段例子很傳神:股東問為什麼買可口可樂,巴菲特講到一半剛好滿五百字,刀落下去,後一張卡片開頭是「它可以年年漲價」,單獨看根本不知道在講誰。Gary 的解法是照自然結構切,股東信照小標題、逐字稿照一輪問答打包,讓問題和答案永遠綁在一起。加 Overlap 只是買保險,治標不治本,這句判斷下得乾脆。
答錯先別急著換更貴的模型
最後那段排查順序我覺得是整支影片最有價值的部分。Gary 拿「哪一年買下喜詩糖果」當例子,答案是 1972 年,分身卻答 1980 年代,然後照資料端、檢索端、小抄端、模型端一層一層查。他直接說實務上八成以上的翻車都在 R 跟 A,根本輪不到模型。這句話對那些一答錯就升級模型的人來說,算是當頭棒喝。
值得下載嗎:值得,特別是已經在動手做知識庫卻卡住的人。它把 RAG 拆成可以照順序排查的流程,不是隻講概念,留下來當實作時的檢查清單很划算。