
YouTube 影片筆記
GPT-6 時代 Codex 四大核心技巧與專案遷移實測整理
原片標題:4 个必须学习的 GPT-6 核心技巧:让你把 Codex 发挥到极致
原片說明
我原本以為 Codex 用得好不好,差別只在提示詞寫得夠不夠細,結果傑森直接說大部分人還停在上一個時代,GPT-6 一發布,舊的框架引導跟防禦性提示詞反而變成拖累。這支影片就是他實測 GPT-6 後整理出的四個核心技巧,從上下文管理一路講到 Agent 工作模式,還附了一份專案遷移檢查清單。
影片時間軸
- 00:43第一個技巧:上下文管理與快取,先講 15 萬 token 舒適區
- 01:44介紹開發者 Matt Pocock 的訪談與 handoff skill
- 04:59跨上下文結構化筆記儲存功能,預設關閉要改 config
- 06:16解釋快取命中,以及 GPT-6 中途改思考強度不再破壞快取
- 07:25強調中途切換模型會同時造成效能下降與快取遺失
- 08:44第二個技巧:Luna、Sol、Astra 三種模型怎麼分配任務
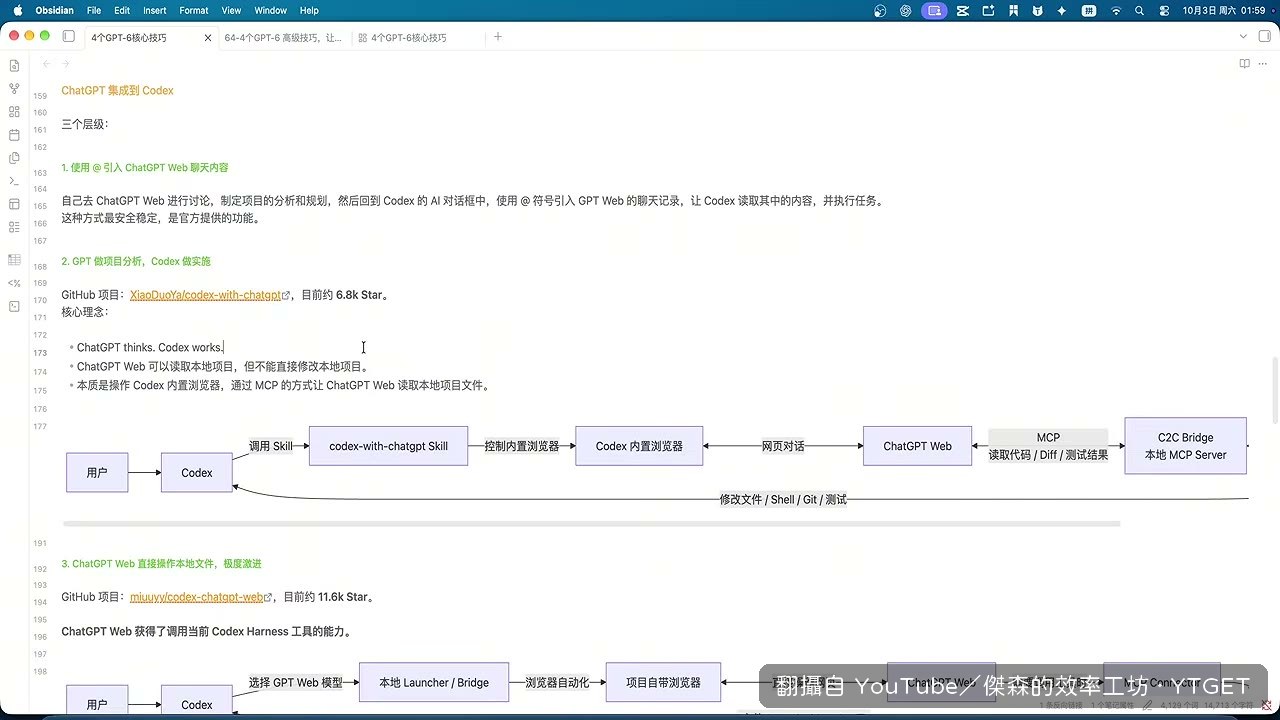
- 10:07三種把 ChatGPT 網頁端接進 Codex 的方法與風險
- 13:07第三個技巧:提示詞與 AGENTS.md 要減少程式性指導
- 16:44第四個技巧:Astra 過度謹慎,許可權與自主權指令怎麼設
- 19:28專案遷移 Checklist,優先處理上下文與指令檔案清理
15 萬 token 才是真正的舒適區
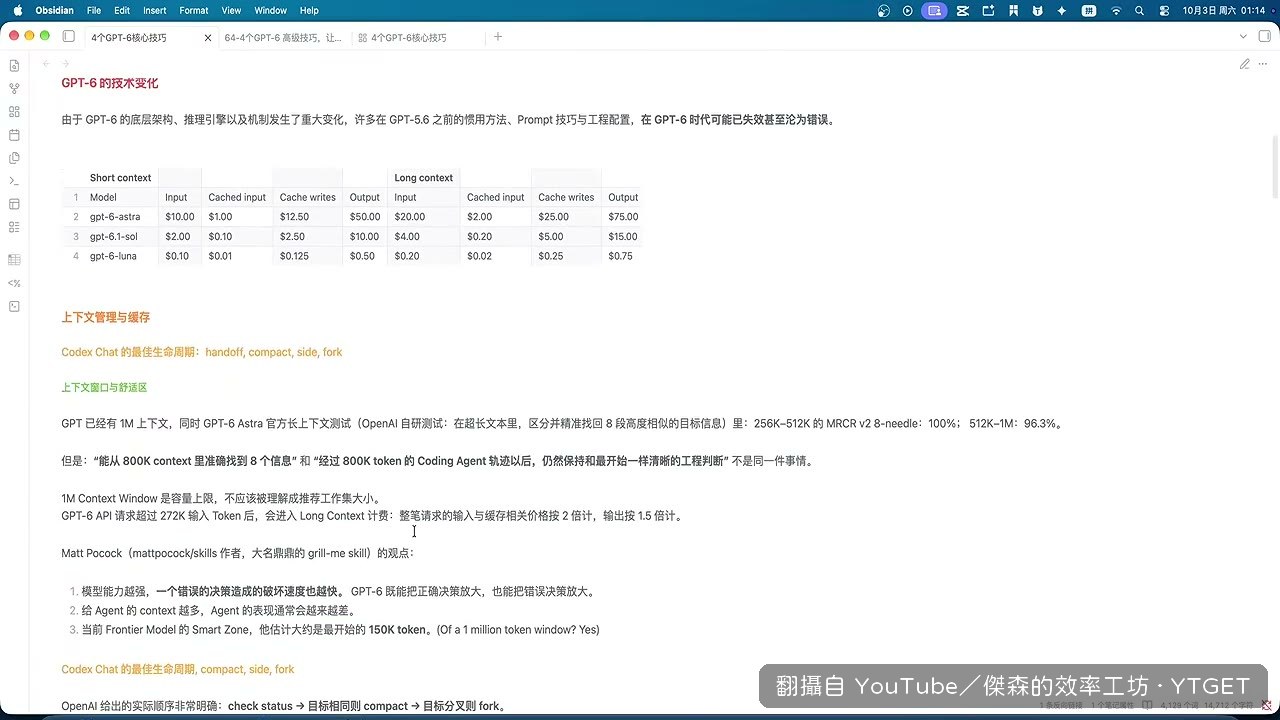
傑森引用了 Matt Pocock 的說法,認為給 Agent 的上下文越多,表現通常越差,GPT-6 這類前沿模型真正高品質的區域只有最前面 15 萬 token,之後就開始變遲鈍。加上 227k 之後快取命中價格會直線上升,所以任務要隨時注意上下文和生命週期。他給了很具體的對應方式:核心目標還在就繼續用同一個對話,太長就用 /compact 壓縮,臨時問題用 /side,想從現有上下文開新任務就用 /fork,新舊任務交接則寫一份 handoff.md。
中途換模型比你想的嚴重
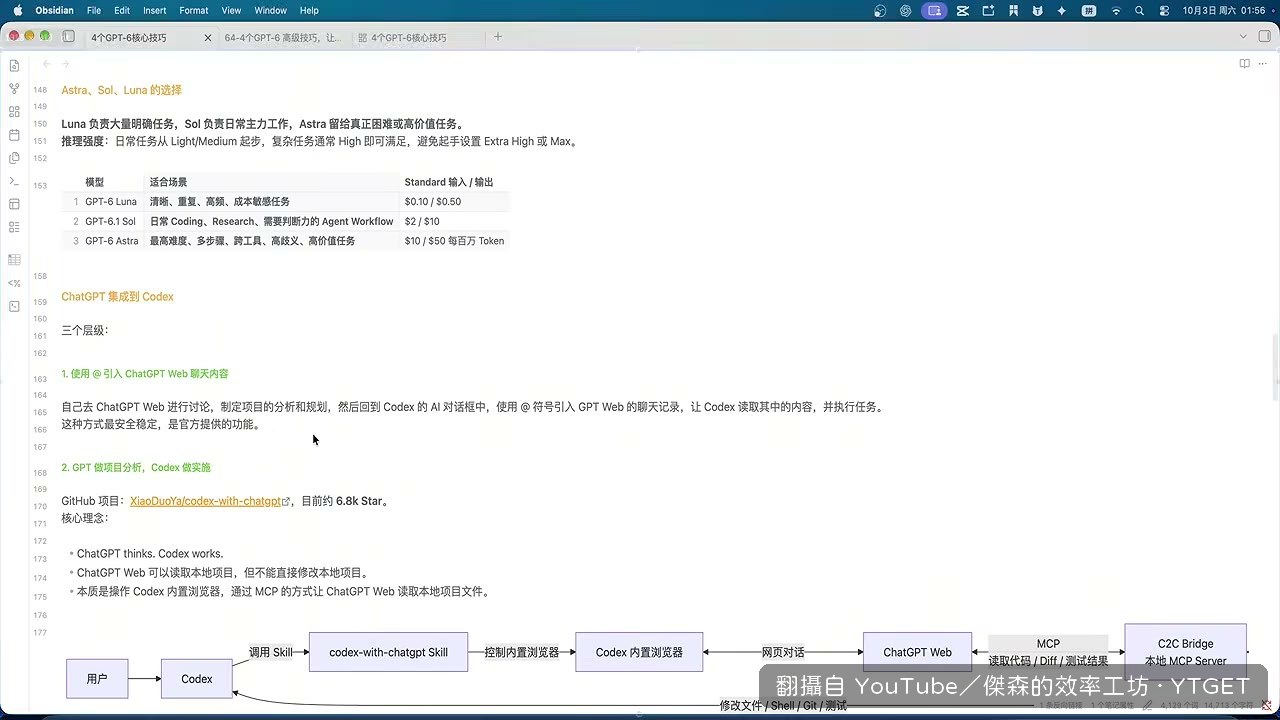
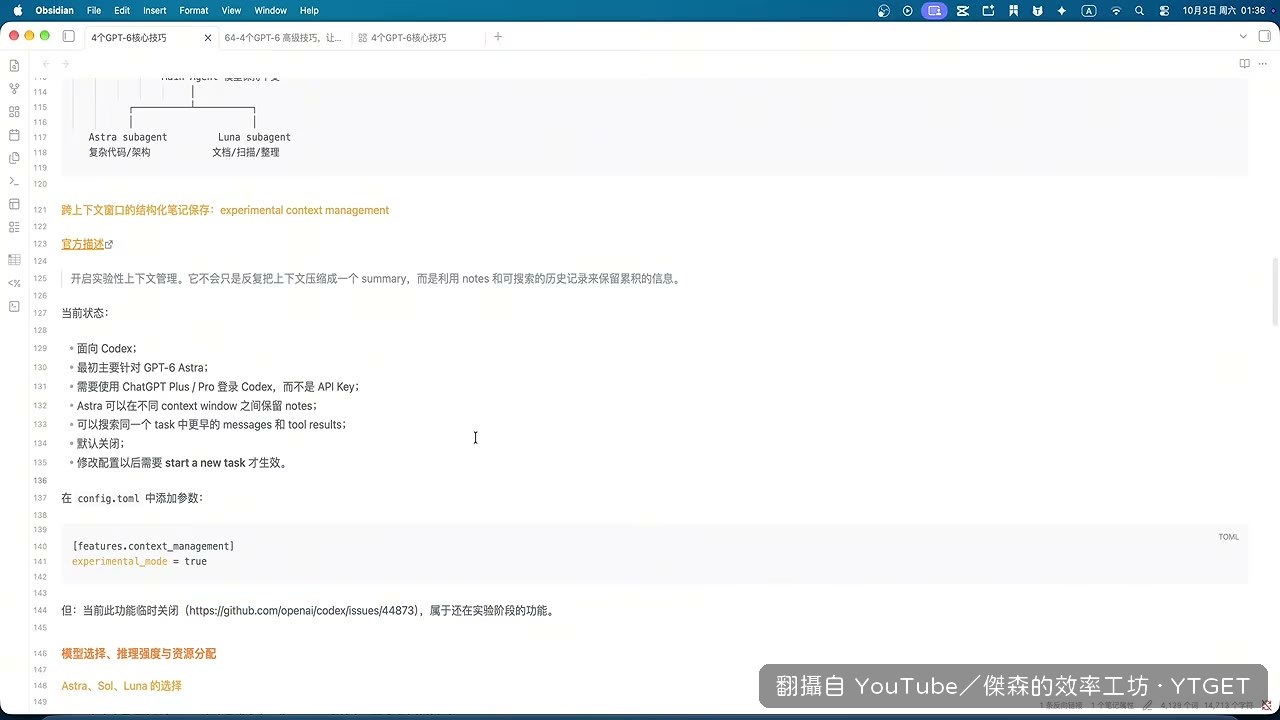
這段是我覺得整支影片最容易被忽略的地方。GPT-6 允許你在同一個對話裡中途調整思考強度,不會破壞快取,這點比 GPT-5.6 Sol 方便。但傑森特別強調,中途切換模型不只是丟快取,連效能都會下降,他同時拿出官方文章、開發者檔案和 Codex 原始碼三個來源佐證。想用不同模型跑不同任務,正確做法是開 subagent,而且 Astra 對子代理偏保守,得在提示詞裡主動要求。
舊提示詞該清掉了
GPT-6 發布後,過去為了效能較弱的模型堆出來的大量框架引導和防禦性提示詞,已經不再有幫助,甚至會限制模型。傑森引用官方文章,核心原則是減少程式性指導、增加任務約束,提示詞改成目標、上下文、約束、完成條件四段式。AGENTS.md 也一樣要精簡,重點是檔案路由、工作契約與驗證機制。skill 的部分他提醒描述要短、觸發條件要精確,同型別的搜尋 skill 裝太多反而會匹配錯誤。
值得下載嗎
如果你已經在用 GPT-6 跑 Codex,這支值得留著,尤其是中途換模型會掉效能、以及提示詞要從步驟式改成約束式這兩段,直接影響你的 token 花費和產出品質。